
















در دنیای هوش مصنوعی و مدلهای زبانی، یادگیری تقویتی از بازخورد انسانی (Human Feedback Reinforcement Learning یا HFRL) به یکی از روشهای کلیدی تبدیل شده است که مدلها را قادر میسازد تا پاسخهای دقیقتر و انسانیتر ارائه دهند. این روش که ترکیبی از یادگیری تقویتی و بازخوردهای انسانی است، به مدلها کمک میکند تا با درک نیازها و انتظارات انسان، عملکرد خود را بهبود بخشند. اما قبل از اقدام به استفاده از این روش، شناخت دقیق آن و درک اهمیت آن برای مدلهای زبانی ضروری است.
یادگیری تقویتی از بازخورد انسانی چیست؟
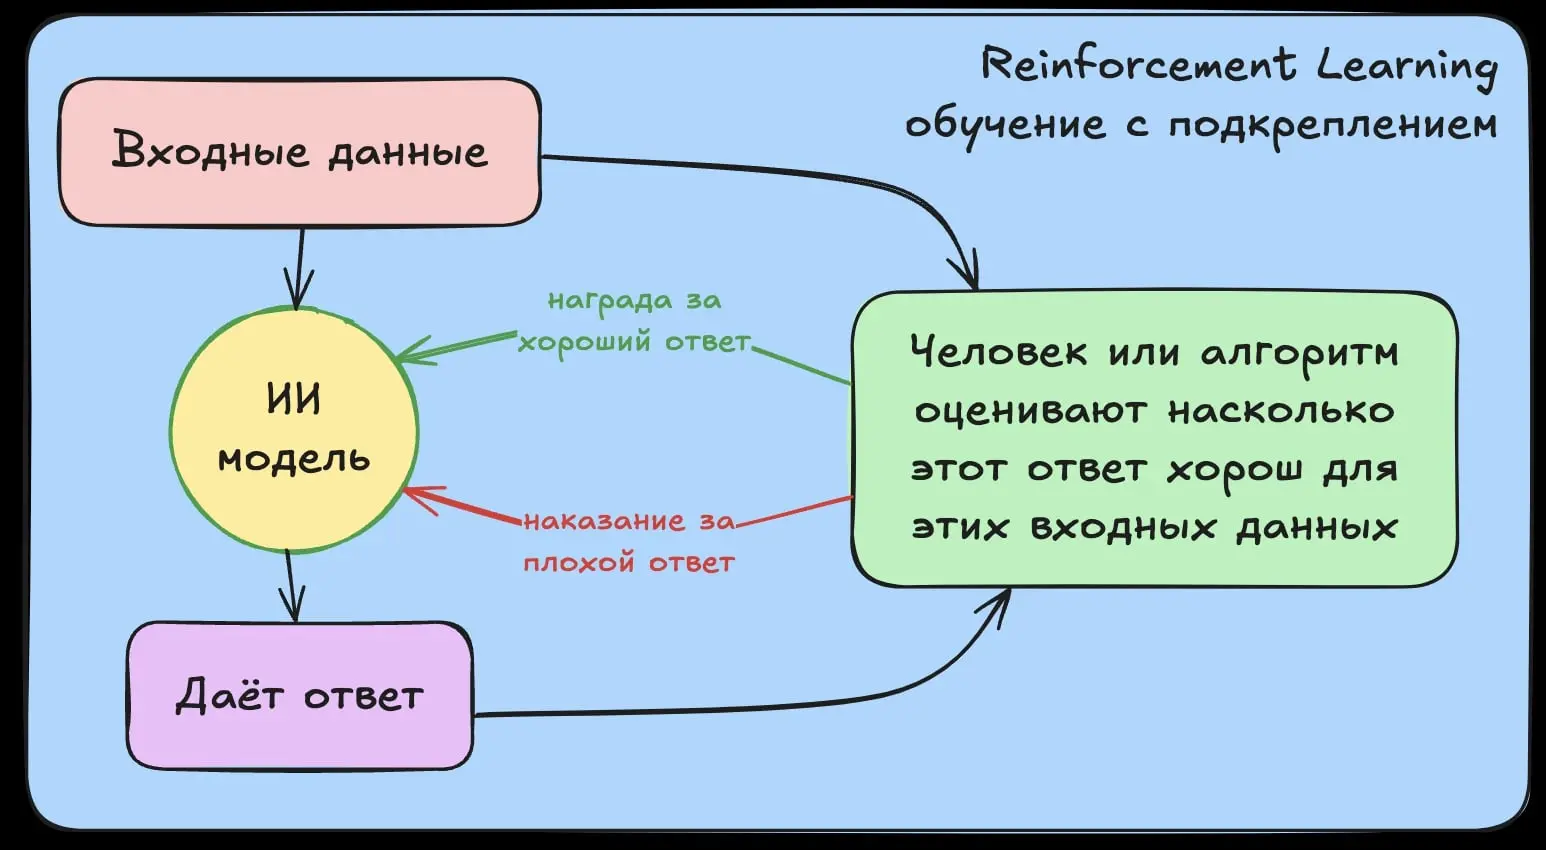
یادگیری تقویتی از بازخورد انسانی یک روش یادگیری ماشین است که در آن مدلهای زبانی با دریافت بازخوردهای مستقیم از انسانها، عملکرد خود را بهبود میبخشند. در این روش، یک مدل زبانی ابتدا پاسخهای خود را ارائه میدهد، سپس این پاسخها توسط انسانها ارزیابی میشوند. بازخوردهای انسانی میتواند شامل امتیازدهی، انتخاب بهترین پاسخ، یا حتی اصلاحات مستقیم باشد. سپس این بازخوردها به عنوان سیگنال تقویتی برای مدل استفاده میشوند تا در پاسخهای بعدی خود بهبود یابد.
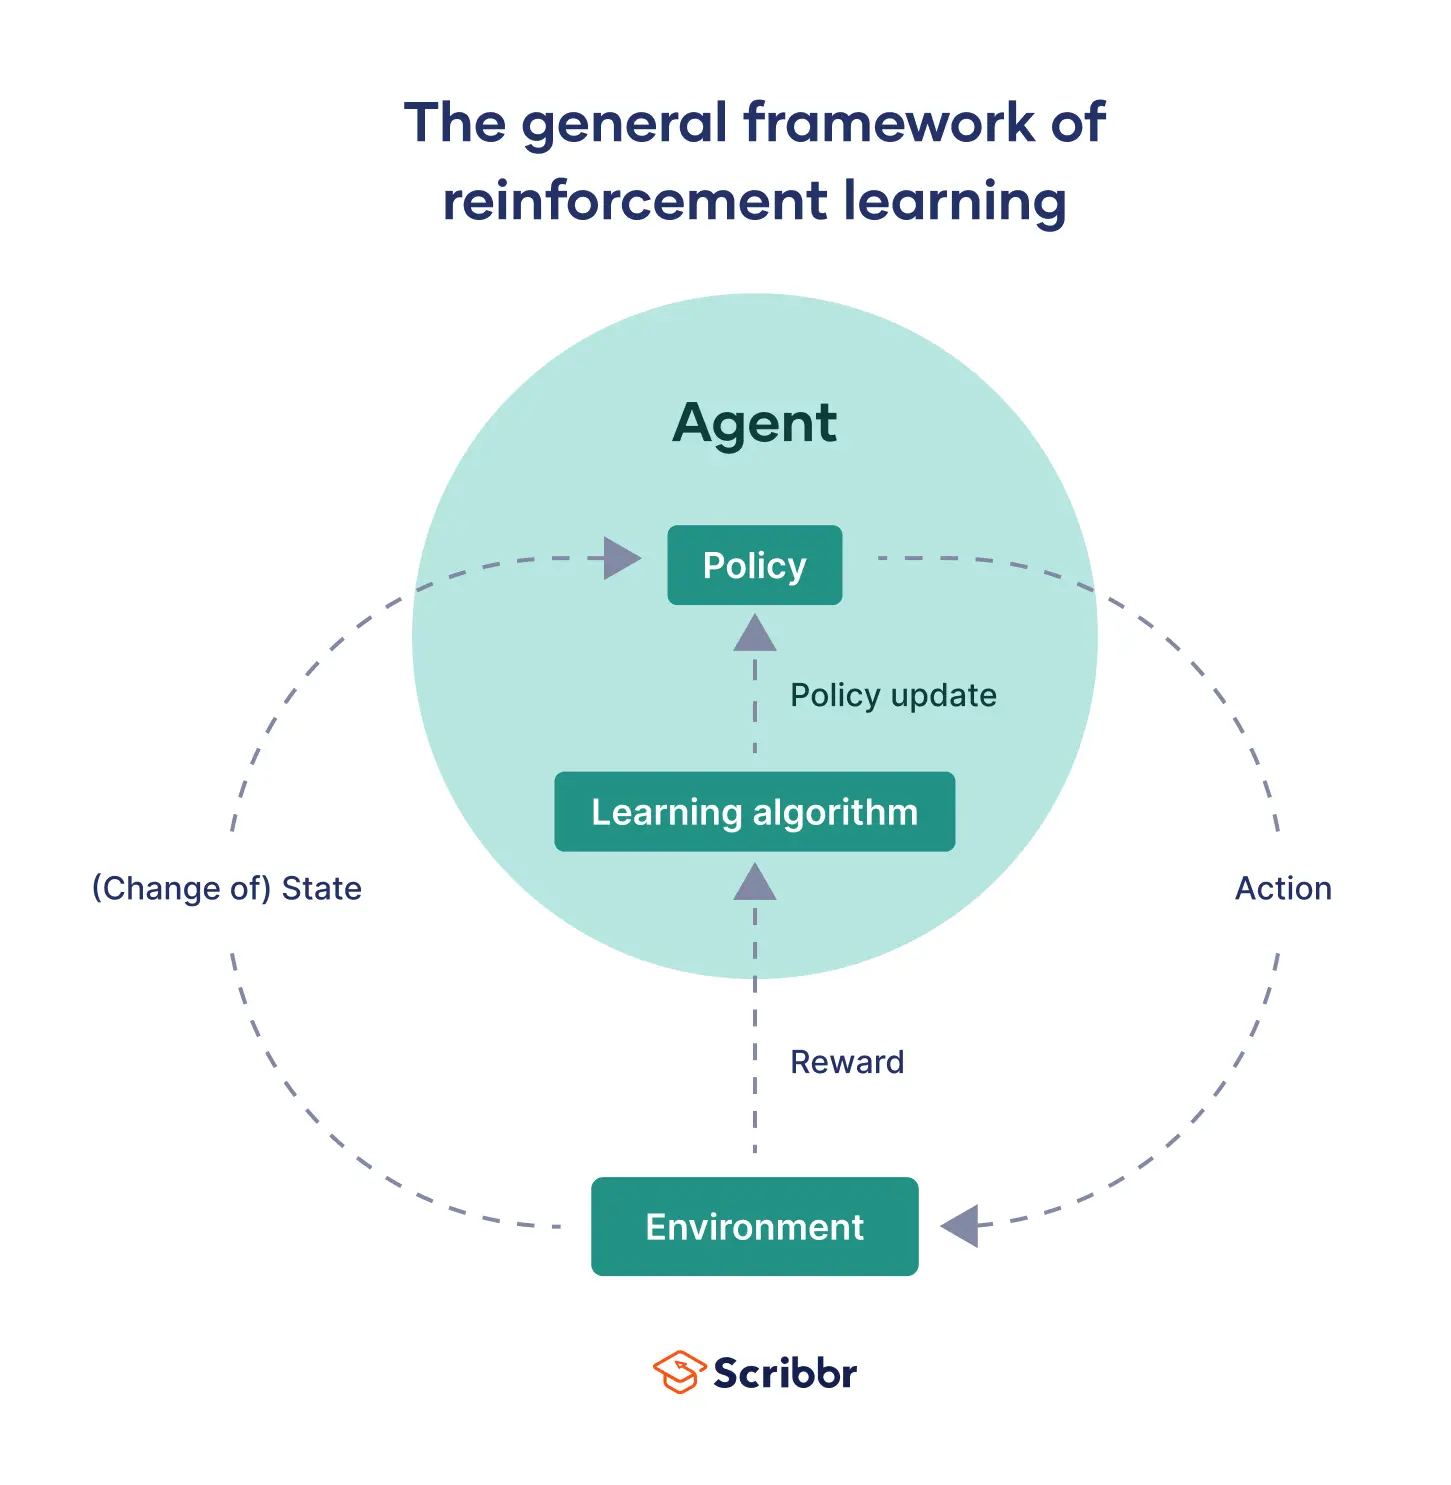
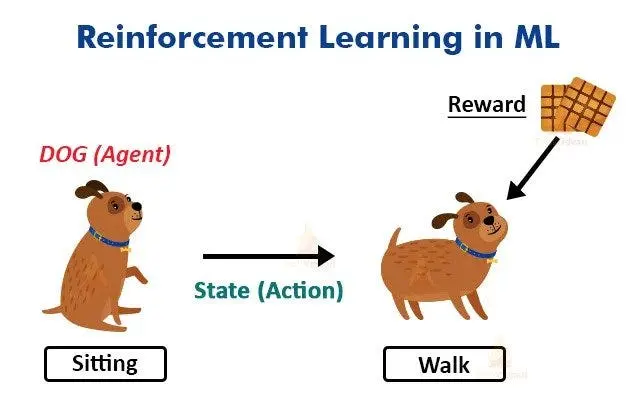
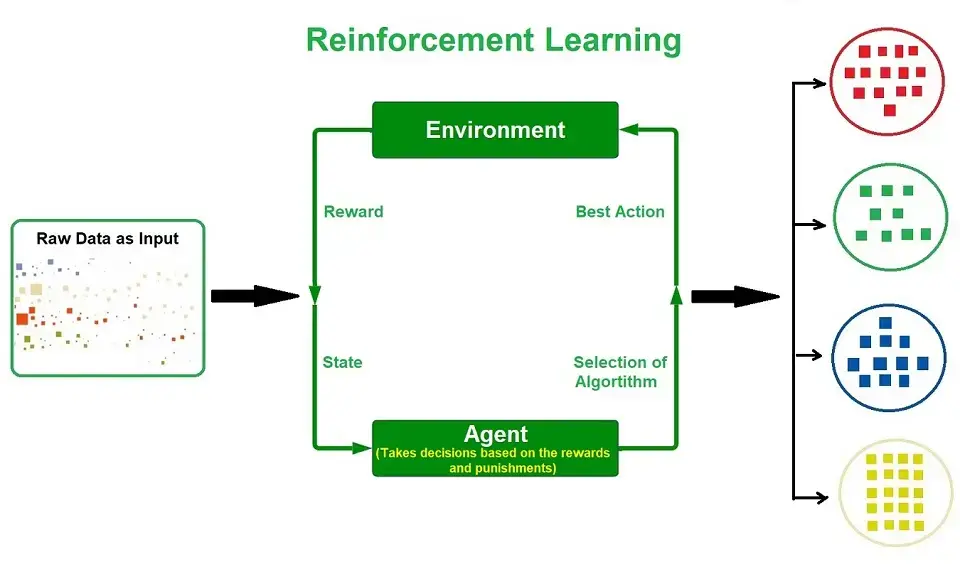
این روش بر اساس اصل یادگیری تقویتی عمل میکند، جایی که یک عامل (در اینجا مدل زبانی) سعی میکند با دریافت پاداش یا تنبیه از محیط (در اینجا انسانها)، عملکرد خود را بهینه کند. در یادگیری تقویتی سنتی، پاداشها از محیط خودکار دریافت میشوند، اما در HFRL، این پاداشها توسط انسانها تعیین میشوند که میتوانند نیازها و انتظارات انسانی را بهتر درک کنند.
به عنوان مثال، اگر یک مدل زبانی سوالی در مورد تاریخ ایران را پاسخ دهد، بازخورد انسانی ممکن است شامل انتخاب بهترین پاسخ از میان چند پاسخ ارائهشده یا حتی اصلاحات مستقیم متن پاسخ باشد. این بازخوردها سپس به مدل نشان میدهند که کدام پاسخها بهتر عمل کردهاند و باید در آینده تکرار شوند.
چرا یادگیری تقویتی از بازخورد انسانی برای مدلهای زبانی مهم است؟
مدلهای زبانی امروزه در بسیاری از کاربردها از جمله چتبوتها، سیستمهای پاسخگویی خودکار، و حتی ترجمههای خودکار استفاده میشوند. اما یکی از چالشهای اصلی این مدلها، ارائه پاسخهایی است که نه تنها دقیق بلکه انسانی و قابل فهم نیز باشند. در اینجا چند دلیل مهم وجود دارد که نشان میدهد چرا HFRL برای مدلهای زبانی حیاتی است:
- دقت و کیفیت پاسخها: بازخوردهای انسانی میتوانند به مدلها کمک کنند تا پاسخهای دقیقتر و با کیفیتتری ارائه دهند. انسانها میتوانند نیازها و انتظارات خاصی را که مدلها ممکن است نتوانند تشخیص دهند، شناسایی کنند.
- همخوانی با ارزشها و فرهنگ: پاسخهای انسانی اغلب با ارزشها و فرهنگ جامعهای که در آن استفاده میشوند، همخوانی دارند. HFRL به مدلها کمک میکند تا این ارزشها را درک کرده و پاسخهای خود را مطابق با آنها تنظیم کنند.
- کاهش خطاهای غیرقابل پیشبینی: مدلهای زبانی ممکن است در شرایطی که دادههای آموزشی کافی ندارند، خطاهای غیرقابل پیشبینی ایجاد کنند. بازخوردهای انسانی میتوانند این خطاها را شناسایی و اصلاح کنند.
- بهبود تعامل: وقتی یک مدل زبانی پاسخهایی ارائه میدهد که انسانها آنها را قابل فهم و مناسب میدانند، تعامل بین انسان و ماشین بهبود مییابد. این امر به ویژه در کاربردهایی مانند خدمات مشتری یا آموزش آنلاین بسیار مهم است.
یکی از نمونههای موفق استفاده از HFRL، مدلهای زبانی مانند GPT-۴ است که با دریافت بازخوردهای انسانی، توانستهاند پاسخهای خود را بهطور قابل توجهی بهبود بخشند. این مدلها با استفاده از بازخوردهای گسترده از کاربران، توانستهاند پاسخهای خود را دقیقتر و انسانیتر کنند.
چگونه یادگیری تقویتی از بازخورد انسانی کار میکند؟
فرآیند HFRL شامل چند مرحله کلی است که هر کدام نقش مهمی در بهبود عملکرد مدل دارند:
- ارائه پاسخ توسط مدل: مدل زبانی ابتدا به یک سوال یا درخواست پاسخ میدهد. این پاسخ ممکن است شامل چندین گزینه یا یک پاسخ مستقیم باشد.
- ارزیابی توسط انسان: یک یا چند انسان، پاسخهای ارائهشده توسط مدل را ارزیابی میکنند. این ارزیابی میتواند شامل امتیازدهی، انتخاب بهترین پاسخ، یا اصلاحات مستقیم باشد.
- تحویل بازخورد به مدل: بازخوردهای انسانی به مدل منتقل میشوند و به عنوان سیگنال تقویتی برای بهبود پاسخهای آینده استفاده میشوند.
- به روزرسانی مدل: مدل با استفاده از این بازخوردها، پارامترهای خود را به روزرسانی میکند تا در پاسخهای بعدی خود بهبود یابد.
این فرآیند معمولاً به صورت تکراری انجام میشود تا مدل بتواند بهطور مداوم بهبود یابد. در برخی موارد، از الگوریتمهای خاصی مانند یادگیری تقویتی عمیق (Deep Reinforcement Learning) استفاده میشود تا مدل بتواند بهطور خودکار از بازخوردهای انسانی یاد بگیرد.
یکی از چالشهای اصلی در HFRL، هزینه و زمان لازم برای دریافت بازخوردهای انسانی است. دریافت بازخورد از انسانها میتواند وقتگیر و گران باشد، بنابراین بسیاری از شرکتها سعی میکنند با استفاده از روشهای خودکار یا نیمه خودکار، این فرآیند را بهینه کنند.
مزایا و چالشهای یادگیری تقویتی از بازخورد انسانی
هر روش جدیدی مزایا و چالشهای خود را دارد. HFRL نیز از این قاعده مستثنی نیست. در زیر به برخی از مزایا و چالشهای این روش میپردازیم:
مزایا:
- بهبود قابل توجه در کیفیت پاسخهای مدلهای زبانی.
- توانایی درک و تطبیق با نیازها و انتظارات انسانی.
- کاهش خطاهای غیرقابل پیشبینی و افزایش دقت.
- افزایش تعامل و رضایت کاربران.
چالشها:
- هزینه و زمان بالای دریافت بازخوردهای انسانی.
- نیاز به مجموعهای بزرگ از بازخوردهای انسانی برای آموزش مدل.
- چالشهای مربوط به موضوعیت و یکنواختی بازخوردها.
- نیاز به سیستمهای خودکار برای کاهش بار انسانی.
برای مقابله با این چالشها، بسیاری از شرکتها از روشهای ترکیبی استفاده میکنند که در آن بازخوردهای انسانی با دادههای خودکار ترکیب میشوند. این روشها میتوانند هزینهها را کاهش داده و در عین حال کیفیت پاسخها را حفظ کنند.
چه مواردی قبل از اقدام به یادگیری تقویتی از بازخورد انسانی باید در نظر گرفته شوند؟
قبل از اقدام به استفاده از HFRL، چندین مورد باید در نظر گرفته شوند تا از موفقیت این روش اطمینان حاصل شود:
- تعریف اهداف واضح: قبل از شروع، باید اهداف دقیقی برای استفاده از HFRL تعیین شود. آیا هدف بهبود کیفیت پاسخها است؟ یا افزایش تعامل با کاربران؟ یا کاهش خطاهای خاصی؟ تعریف اهداف واضح میتواند فرآیند را هدایت کند.
- انتخاب گروه بازخورددهندگان: گروه بازخورددهندگان باید متناسب با هدف مدل انتخاب شوند. برای مثال، اگر مدل برای پاسخگویی به سوالات پزشکی طراحی شده است، بازخورددهندگان باید متخصصان پزشکی باشند.
- طراحی فرآیند بازخورد: فرآیند دریافت بازخورد باید به گونهای طراحی شود که سریع، کارآمد و قابل اندازهگیری باشد. استفاده از ابزارهای خودکار یا نیمه خودکار میتواند این فرآیند را سادهتر کند.
- ارزیابی مداوم: پس از شروع فرآیند، باید بهطور مداوم عملکرد مدل را ارزیابی کرد تا اطمینان حاصل شود که بازخوردهای انسانی به درستی استفاده میشوند و مدل در حال بهبود است.
- کاهش هزینهها: دریافت بازخوردهای انسانی میتواند گران باشد، بنابراین باید راههایی برای کاهش هزینهها مانند استفاده از بازخوردهای خودکار یا کاهش تعداد بازخوردهای لازم پیدا کرد.
همچنین، باید توجه داشت که HFRL یک فرآیند طولانیمدت است و نتایج آن ممکن است به زمان نیاز داشته باشد. صبر و استقامت در این فرآیند بسیار مهم است.
آینده یادگیری تقویتی از بازخورد انسانی
با پیشرفت فناوری و افزایش استفاده از مدلهای زبانی، HFRL نیز در حال تکامل است. در آینده، میتوان انتظار داشت که این روش با استفاده از روشهای پیشرفتهتری مانند یادگیری تقویتی عمیق، یادگیری فدرال، و استفاده از دادههای بزرگتر، بهبود بیشتری یابد.
یکی از زمینههای مهم آینده HFRL، استفاده از بازخوردهای چندگانه است. در این روش، بازخوردهای انسانی از منابع مختلف مانند کاربران، متخصصان، و حتی سیستمهای خودکار ترکیب میشوند تا مدل بتواند از دیدگاههای مختلفی یاد بگیرد.
همچنین، با پیشرفت فناوریهای خودکار، ممکن است بخش بیشتری از فرآیند بازخورد توسط سیستمها انجام شود، در حالی که بازخوردهای انسانی برای موارد پیچیدهتر و نیازهای خاص استفاده شوند.
در نهایت، HFRL میتواند نقش مهمی در ایجاد مدلهای زبانی ایفا کند که نه تنها دقیق بلکه انسانی و قابل اعتماد نیز باشند. این امر میتواند تعامل بین انسان و ماشین را به سطح جدیدی برساند و کاربردهای جدیدی را برای هوش مصنوعی باز کند.
برای اطلاعات بیشتر در مورد روشهای پیشرفته یادگیری ماشین و هوش مصنوعی، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید. این مقالات میتوانند دیدگاههای جدیدی را در مورد چگونگی بهبود مدلهای زبانی با استفاده از روشهای مختلف ارائه دهند.