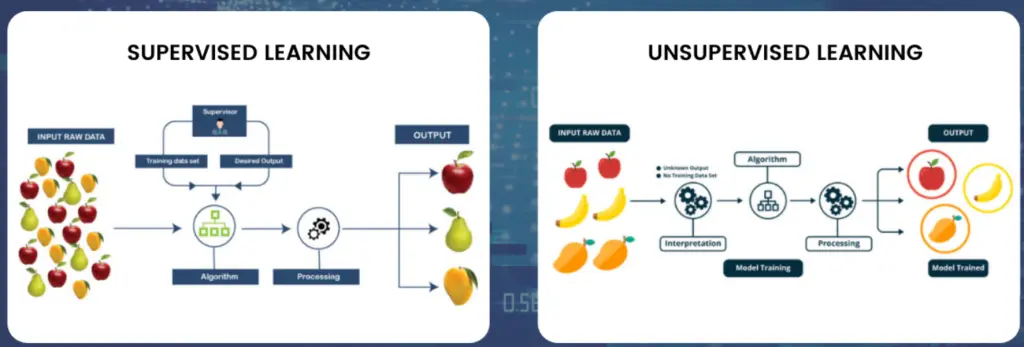
در دنیای یادگیری ماشین و هوش مصنوعی، روشهای مختلفی برای آموزش الگوریتمها وجود دارد. یکی از مهمترین و پرکاربردترین این روشها، یادگیری بدون نظارت است. این روش به الگوریتمها اجازه میدهد تا بدون نیاز به دادههای برچسبدار، الگوهای پنهان در دادهها را کشف کنند. اما چگونه این روش کار میکند؟ چه کاربردهایی دارد؟ و چرا در بسیاری از پروژههای دادهکاوی و تحلیل دادهها استفاده میشود؟ در این راهنما، به طور ساده و کاربردی به این سوالات پاسخ میدهیم و همچنین نحوه شروع کار با یادگیری بدون نظارت را توضیح میدهیم.
یادگیری بدون نظارت چیست؟
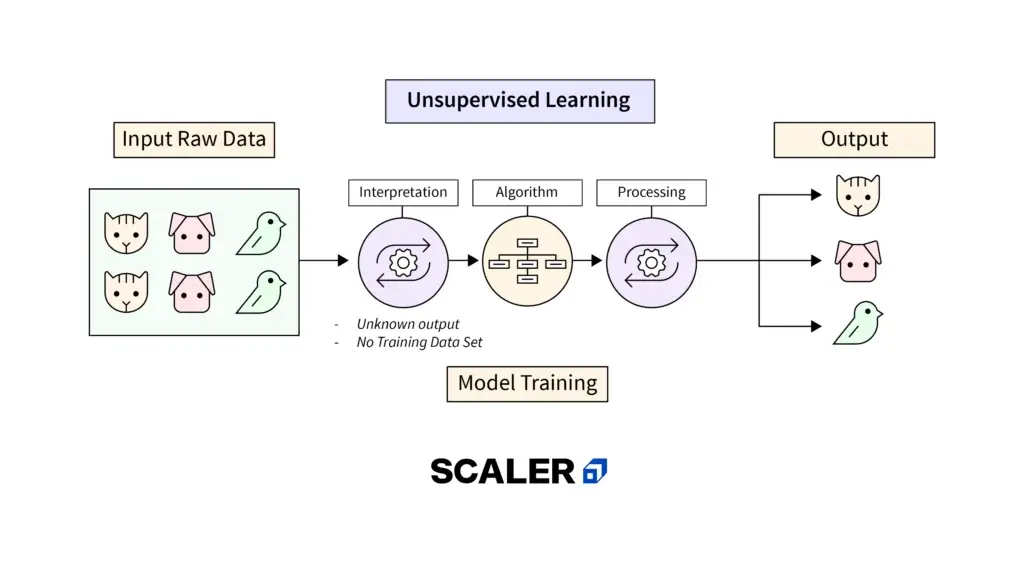
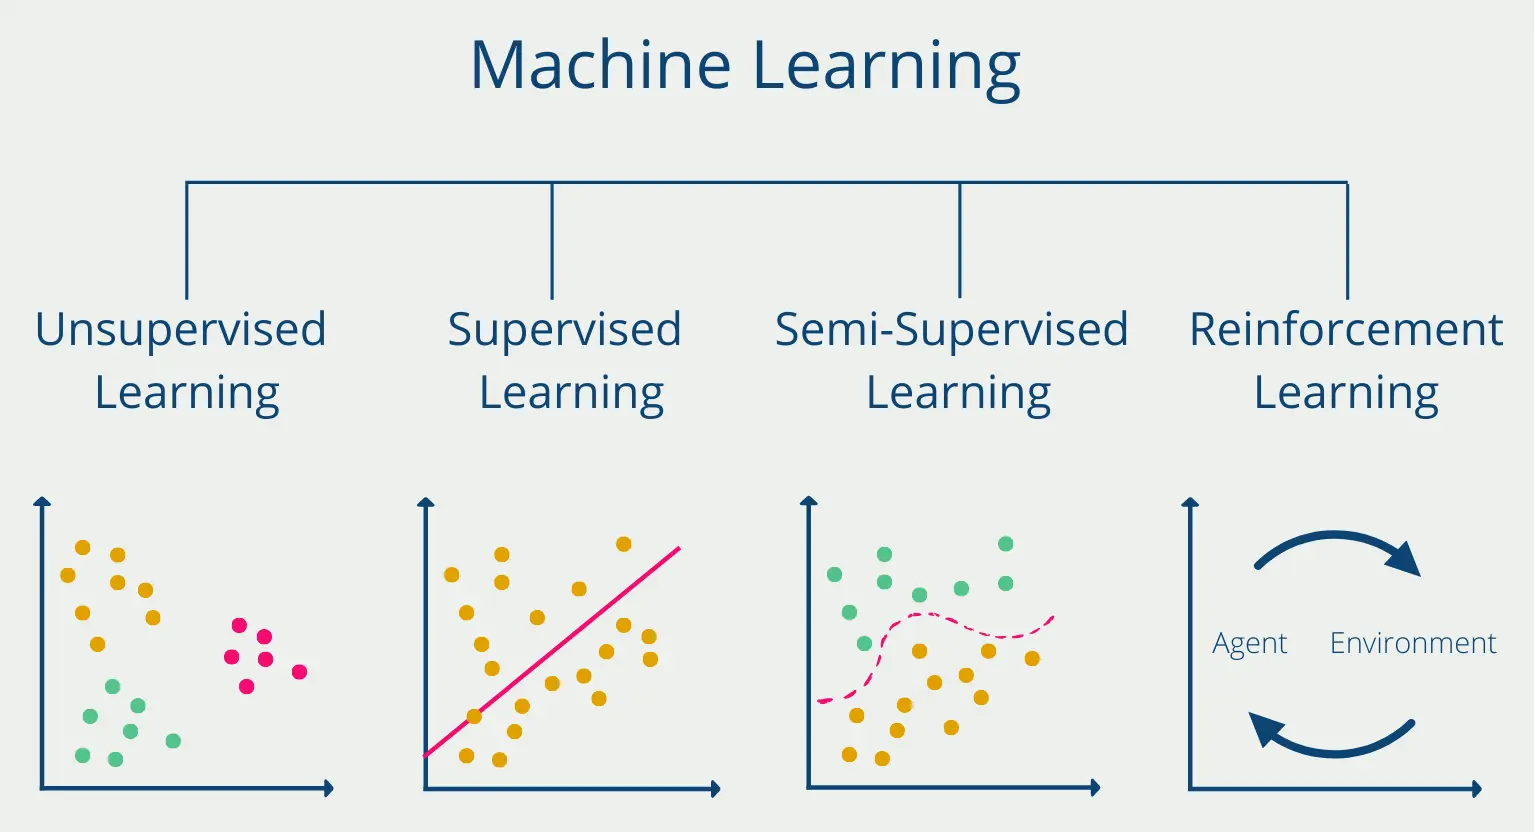
یادگیری بدون نظارت (Unsupervised Learning) یکی از سه روش اصلی یادگیری ماشین است، دو روش دیگر یادگیری با نظارت (Supervised Learning) و یادگیری تقویتی (Reinforcement Learning) هستند. در یادگیری بدون نظارت، الگوریتمها با دادههایی کار میکنند که برچسب یا پاسخ مشخصی ندارند. هدف اصلی این روش، کشف ساختارهای پنهان، الگوها یا گروهبندی دادهها است، بدون اینکه قبلاً به الگوریتم گفته شود چه چیزی را باید پیدا کند.
به عبارت دیگر، در یادگیری بدون نظارت، الگوریتم مانند یک دانشآموز است که در کلاس بدون معلم و بدون کتاب پاسخنامه، سعی میکند از دادهها الگوهای جدیدی را کشف کند. این روش در شرایطی که دادههای برچسبدار کمیاب یا گران هستند، بسیار مفید است.
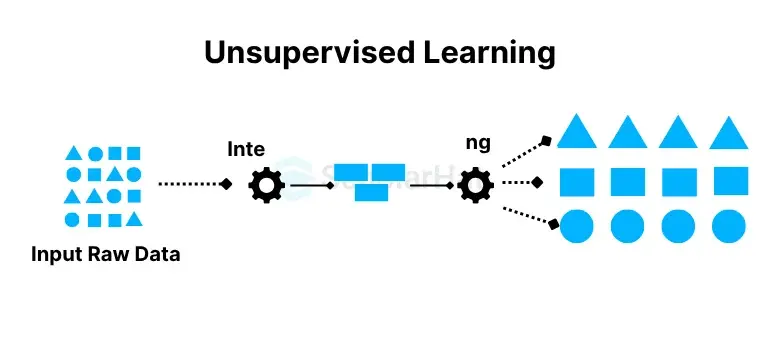
چگونه یادگیری بدون نظارت الگوهای پنهان دادهها را پیدا میکند؟
الگوریتمهای یادگیری بدون نظارت با استفاده از تکنیکهای مختلف، سعی میکنند ساختارهای پنهان در دادهها را شناسایی کنند. دو روش اصلی در این زمینه وجود دارد:
- کلاسترینگ (Clustering): این روش دادهها را به گروههای مشابه تقسیم میکند، به طوری که دادههای داخل هر گروه به یکدیگر شبیهتر باشند و دادههای گروههای مختلف از یکدیگر متفاوتتر باشند. مثال معروفی از این روش، الگوریتم K-Means است که دادهها را به k گروه تقسیم میکند.
- کاهش ابعاد (Dimensionality Reduction): در بسیاری از پروژهها، دادهها دارای تعداد زیادی ویژگی (dimension) هستند که تحلیل آنها دشوار است. روشهای مانند PCA (Principal Component Analysis) یا t-SNE، سعی میکنند دادهها را به ابعاد کمتری کاهش دهند، در حالی که اطلاعات مهم را حفظ میکنند.
این الگوریتمها با استفاده از روشهای ریاضی و آماری، مانند فاصله بین دادهها، شباهتها، یا توزیع دادهها، سعی میکنند ساختارهای پنهان را کشف کنند. برای مثال، در یک مجموعه داده شامل اطلاعات مشتریان یک فروشگاه، الگوریتم میتواند گروههایی از مشتریان را شناسایی کند که رفتار خرید مشابهی دارند، بدون اینکه قبلاً به الگوریتم گفته شود چه گروههایی باید پیدا کند.
کاربردهای یادگیری بدون نظارت
یادگیری بدون نظارت در بسیاری از زمینهها کاربرد دارد. برخی از مهمترین کاربردها عبارتند از:
- گروهبندی مشتریان: شرکتها میتوانند با استفاده از این روش، مشتریان خود را به گروههای مختلف تقسیم کنند و استراتژیهای بازاریابی هدفمندتری را طراحی کنند.
- تشخیص انحراف: در سیستمهای مالی یا شبکههای کامپیوتری، این روش میتواند فعالیتهای غیرعادی یا انحرافی را شناسایی کند.
- کاهش ابعاد دادهها: در پروژههای دادهکاوی، این روش کمک میکند تا دادهها را سادهتر و قابل تحلیلتر کنند.
- پیشبینی: در برخی موارد، الگوریتمهای بدون نظارت میتوانند برای پیشبینی استفاده شوند، مانند پیشبینی ترندهای اجتماعی یا اقتصادی.
این روش همچنین در زمینههای مانند زیستشناسی، پزشکی، و حتی هنر کاربرد دارد. برای مثال، در زیستشناسی، میتوان از آن برای تحلیل دادههای ژنتیکی و کشف الگوهای پنهان در ژنها استفاده کرد.
چگونه شروع به کار با یادگیری بدون نظارت کنیم؟
اگر میخواهید با یادگیری بدون نظارت شروع کنید، مراحل زیر را دنبال کنید:
مرحله ۱: درک دادهها
اولین قدم، درک ساختار و نوع دادههای خود است. دادهها باید مناسب برای تحلیل بدون نظارت باشند. برای مثال، اگر دادههای شما شامل ویژگیهای کمی هستند (مانند سن، درآمد)، میتوانید از روشهای مانند K-Means استفاده کنید. اما اگر دادهها شامل ویژگیهای کیفی هستند (مانند رنگ یا نوع محصول)، ممکن است نیاز به پیشپردازش داشته باشید.
مرحله ۲: انتخاب الگوریتم مناسب
بعد از درک دادهها، باید الگوریتم مناسب را انتخاب کنید. برخی از الگوریتمهای پرکاربرد عبارتند از:
- K-Means برای گروهبندی دادهها
- DBSCAN برای شناسایی گروههای با شکلهای مختلف
- PCA برای کاهش ابعاد دادهها
- t-SNE برای تجسم دادهها در ابعاد کم
انتخاب الگوریتم بستگی به نوع دادهها و هدف شما دارد. برای مثال، اگر میخواهید دادهها را به گروههای مشخص تقسیم کنید، K-Means یک انتخاب خوب است. اما اگر دادهها دارای شکلهای پیچیدهای هستند، ممکن است DBSCAN بهتر باشد.
مرحله ۳: پیشپردازش دادهها
پیشپردازش دادهها یکی از مهمترین مراحل است. دادهها باید تمیز، کامل و در یک فرمت مناسب باشند. این شامل موارد زیر است:
- پاکسازی دادهها از مقادیر ناهنجار یا خطا
- نرم کردن یا استانداردسازی دادهها (مانند تبدیل دادهها به مقیاس مشابه)
- کدگذاری ویژگیهای کیفی (مانند تبدیل متن به عدد)
پیشپردازش مناسب میتواند تأثیر زیادی بر نتیجه نهایی داشته باشد. برای مثال، اگر دادههای شما دارای مقادیر بسیار بزرگ یا کوچک هستند، استانداردسازی آنها میتواند به الگوریتم کمک کند تا بهتر کار کند.
مرحله ۴: اجرای الگوریتم و ارزیابی نتایج
بعد از آمادهسازی دادهها، میتوانید الگوریتم انتخابی را اجرا کنید. اما چگونه میتوانید نتیجه را ارزیابی کنید؟ در یادگیری بدون نظارت، برچسبهای مشخصی وجود ندارد، بنابراین ارزیابی کمی دشوارتر است. اما میتوانید از روشهای زیر استفاده کنید:
- تحلیل بصری: با استفاده از نمودارهای مختلف، مانند نمودارهای پراکندگی یا نمودارهای گروهبندی، میتوانید نتایج را بصری بررسی کنید.
- متریکهای داخلی: برخی از الگوریتمها، مانند K-Means، دارای متریکهای داخلی هستند که میتوانید از آنها برای ارزیابی استفاده کنید.
- تجزیه و تحلیل تخصصی: اگر در زمینه خاصی کار میکنید، میتوانید با استفاده از دانش تخصصی خود، نتایج را ارزیابی کنید.
برای مثال، اگر دادههای شما مربوط به مشتریان یک فروشگاه است، میتوانید گروههای شناسایی شده را با دانش بازاریابی خود بررسی کنید و ببینید آیا گروهبندی منطقی است یا خیر.
چالشهای یادگیری بدون نظارت
در حالی که یادگیری بدون نظارت بسیار قدرتمند است، اما چالشهایی نیز دارد:
- عدم وجود برچسب: بدون برچسب، ارزیابی نتایج دشوار است و ممکن است نتایج چندگانه وجود داشته باشد.
- انتخاب پارامترها: بسیاری از الگوریتمها نیاز به تنظیم پارامترهای مختلف دارند، مانند تعداد گروهها در K-Means.
- پیشپردازش دادهها: دادههای ناکافی یا نامناسب میتواند منجر به نتایج نادرست شود.
با این حال، با درک مناسب و تجربه، میتوانید این چالشها را مدیریت کنید و از قدرت یادگیری بدون نظارت بهرهبرداری کنید.
یادگیری بدون نظارت در دنیای واقعی
یادگیری بدون نظارت در بسیاری از شرکتها و سازمانها استفاده میشود. برای مثال:
- شرکتهای فناوری مانند گوگل و فیسبوک از این روش برای توصیه سیستمها و گروهبندی کاربر استفاده میکنند.
- بانکها از آن برای تشخیص فعالیتهای مشکوک مالی استفاده میکنند.
- شرکتهای بازاریابی از آن برای تحلیل رفتار مشتریان و تقسیمبندی آنها استفاده میکنند.
اگر شما نیز در زمینه دادهکاوی یا تحلیل دادهها فعالیت میکنید، یادگیری بدون نظارت میتواند ابزاری قدرتمند برای کشف اطلاعات پنهان در دادهها باشد. برای یادگیری بیشتر در مورد روشهای مختلف یادگیری ماشین و کاربردهای آنها، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید.
در پایان، یادگیری بدون نظارت یک روش قدرتمند برای کشف الگوهای پنهان در دادهها است. با درک اصول اساسی و استفاده از الگوریتمهای مناسب، میتوانید از این روش برای حل مشکلات مختلف استفاده کنید. اگر به دنبال شروع کار با این روش هستید، پیشنهاد میکنیم با دادههای ساده شروع کنید و با تجربه، به پروژههای پیچیدهتر بروید.