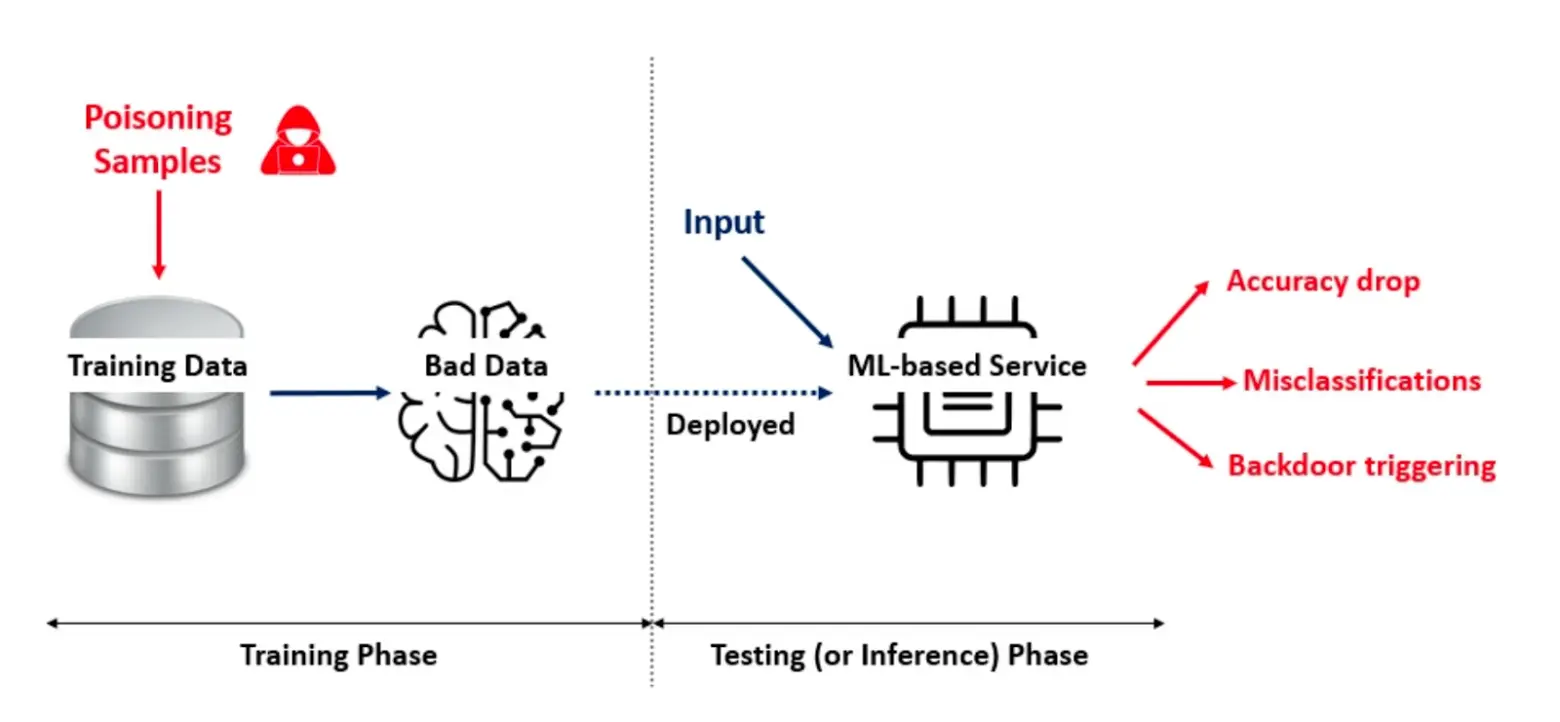
در دنیای امروزی که هوش مصنوعی به یکی از مهمترین ابزارهای تصمیمگیری و تحلیل تبدیل شده است، دقت و کیفیت دادههای ورودی نقش اساسی در عملکرد مدلهای AI ایفا میکنند. یکی از چالشهای اساسی که میتواند آموزش مدلهای هوش مصنوعی را به شدت تحت تأثیر قرار دهد، مسمومسازی داده است. این پدیده که به انگلیسی Data Poisoning شناخته میشود، به معنای آلودگی عمدی یا تصادفی دادههای آموزشی است تا عملکرد مدل را به سمت نتایج نادرست یا غیرمنتظره هدایت کند. در این مقاله، به بررسی مفاهیم اساسی مسمومسازی داده، روشهای انجام آن، تأثیرات آن بر مدلهای هوش مصنوعی و راهکارهای مقابله با این مشکل میپردازیم.
مسمومسازی داده چیست؟
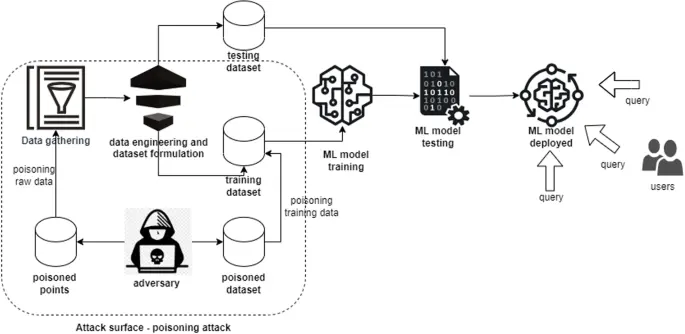
مسمومسازی داده به فرایندی گفته میشود که در آن دادههای آموزشی مدل هوش مصنوعی به صورت عمدی یا غیرعمدی تغییر مییابند تا الگوریتم در تشخیص و پیشبینی صحیح دچار مشکل شود. این تغییرات میتواند شامل اضافه کردن دادههای نادرست، تغییر مقادیر واقعی، یا حتی حذف دادههای مهم باشد. هدف از مسمومسازی داده معمولاً ایجاد bias (پیشداوری)، کاهش دقت مدل، یا حتی تغییر رفتار مدل به نفع یک گروه خاص است.
مسمومسازی داده میتواند به دو صورت اصلی رخ دهد:
- مسمومسازی عمدی: در این حالت، افراد یا گروههایی با هدف خاصی مانند کاهش دقت مدل، تغییر نتایج به نفع خود، یا حتی خرابکاری، دادهها را آلوده میکنند.
- مسمومسازی غیرعمدی: این نوع مسمومسازی معمولاً ناشی از خطاهای انسانی یا فنی در جمعآوری یا پردازش دادهها است، مانند ثبت اطلاعات نادرست یا عدم تطبیق دادهها با واقعیت.
مسمومسازی داده میتواند در هر مرحله از چرخه زندگی دادهها، از جمعآوری تا پردازش و آموزش مدل، رخ دهد. برای مثال، در سیستمهای تشخیص چهره، اگر دادههای آموزشی عمدی یا غیرعمدی با کیفیت پایین یا نادرست باشند، مدل ممکن است در تشخیص افراد با ویژگیهای خاص دچار مشکل شود.
چگونه مسمومسازی داده آموزش مدل هوش مصنوعی را مختل میکند؟
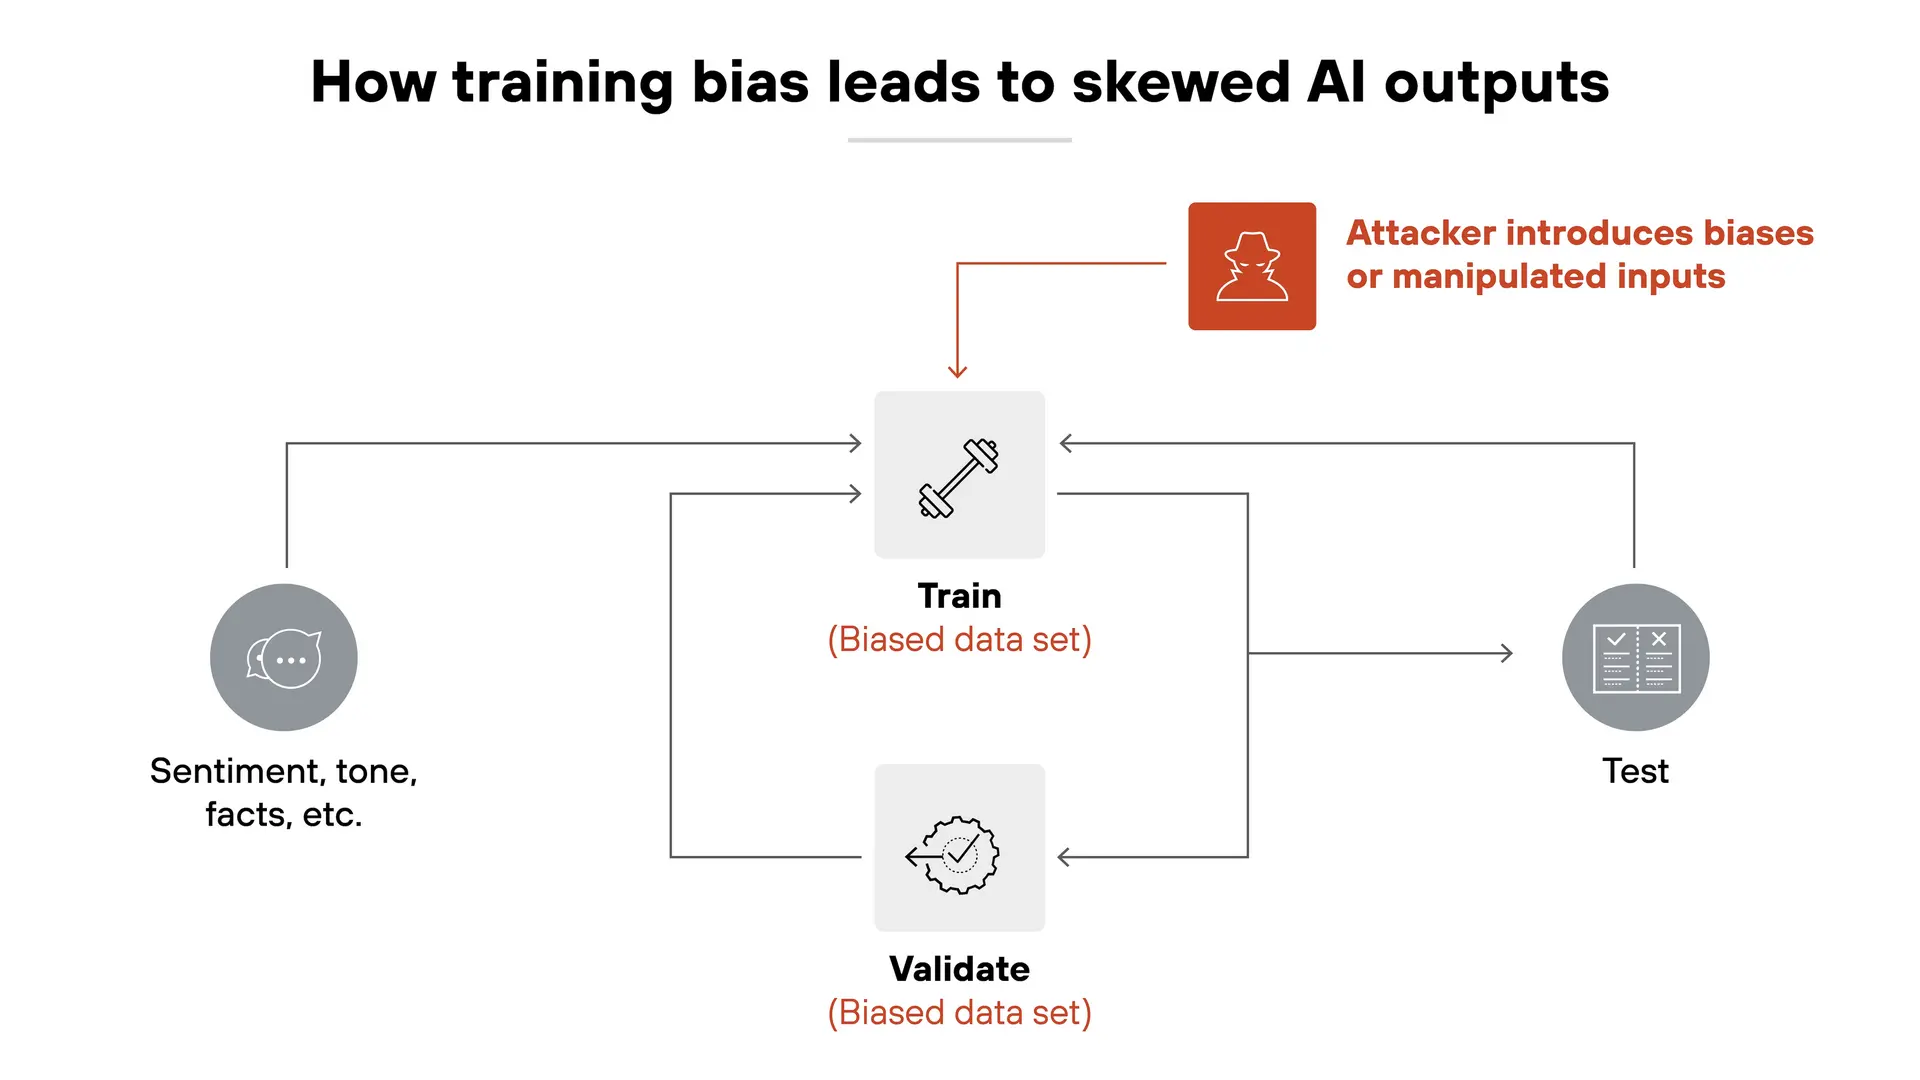
مسمومسازی داده میتواند به چندین روش مختلف آموزش مدل هوش مصنوعی را مختل کند. برخی از این روشها شامل:
- افزایش bias (پیشداوری): اگر دادههای آموزشی به صورت ناعادلانه جمعآوری شوند یا تغییر یابند، مدل ممکن است به سمت نتایجی که با واقعیت مطابقت ندارند، هدایت شود. برای مثال، اگر در یک مدل تشخیص بیماری، دادههای مربوط به یک گروه خاص از بیماران عمدی یا غیرعمدی حذف یا تغییر یابند، مدل ممکن است در تشخیص بیماری در آن گروه دچار خطا شود.
- کاهش دقت: دادههای آلوده میتوانند باعث شوند مدل نتواند الگوهای واقعی را تشخیص دهد و دقت پیشبینیهایش کاهش یابد. این موضوع در سیستمهای حساس مانند تشخیص سرطان یا پیشبینی بازارهای مالی بسیار خطرناک است.
- تغییر رفتار مدل: در برخی موارد، مسمومسازی داده میتواند باعث شود مدل به سمت نتایجی که برای یک گروه خاص مفید است، تغییر کند. برای مثال، در سیستمهای توصیهگر، دادههای آلوده میتواند باعث شود مدل محصولات خاصی را به کاربران توصیه کند که ممکن است با ترجیحات واقعی آنها مطابقت نداشته باشد.
- خرابکاری: در مواردی که مسمومسازی داده به صورت عمدی انجام میشود، میتواند منجر به خرابکاری در سیستمها شود. برای مثال، در سیستمهای خودران، آلودگی دادهها میتواند باعث شود خودروها رفتارهای غیرمنتظرهای از خود نشان دهند و خطرات جدی ایجاد کنند.
یکی از مهمترین چالشهای مسمومسازی داده، تشخیص آن در دادههای بزرگ است. به دلیل حجم بالای دادهها و پیچیدگی الگوریتمها، شناسایی دادههای آلوده به صورت دستی یا حتی با استفاده از ابزارهای خودکار بسیار دشوار است.
روشهای مسمومسازی داده و مثالهای واقعی
مسمومسازی داده میتواند به روشهای مختلفی انجام شود. برخی از این روشها شامل:
- اضافه کردن دادههای نادرست: در این روش، دادههای کاملا نادرست یا غیرمعمول به مجموعه دادههای آموزشی اضافه میشوند. این دادهها میتوانند باعث شوند مدل نتواند الگوهای واقعی را تشخیص دهد.
- تغییر مقادیر داده: در این روش، مقادیر واقعی دادهها تغییر مییابند. برای مثال، در دادههای مربوط به سن، ممکن است مقادیر عمدی یا غیرعمدی تغییر یابند تا مدل به سمت نتایجی که با واقعیت مطابقت ندارند، هدایت شود.
- حذف دادههای مهم: در برخی موارد، دادههای مهم و حیاتی از مجموعه دادههای آموزشی حذف میشوند. این موضوع میتواند باعث شود مدل نتواند الگوهای مهم را تشخیص دهد.
- اضافه کردن نویز: اضافه کردن نویز به دادهها میتواند باعث شود مدل نتواند الگوهای واقعی را تشخیص دهد. این روش معمولاً در دادههای صوتی یا تصویری استفاده میشود.
- تغییر توزیع دادهها: در این روش، توزیع دادهها تغییر مییابد تا مدل نتواند الگوهای واقعی را تشخیص دهد. برای مثال، اگر در دادههای مربوط به تشخیص بیماری، توزیع دادهها به صورت ناعادلانه تغییر یابد، مدل ممکن است در تشخیص بیماری در گروههای خاص دچار مشکل شود.
یکی از مثالهای معروف مسمومسازی داده در دنیای واقعی، استفاده از دادههای نادرست در سیستمهای تشخیص چهره است. در برخی موارد، دادههای مربوط به افراد با پوست تیره یا زنان کمتر در مجموعه دادههای آموزشی حضور داشتهاند، که این موضوع باعث شده است مدلها در تشخیص چهره این گروهها دچار خطا شوند.
چگونه میتوان از مسمومسازی داده جلوگیری کرد؟
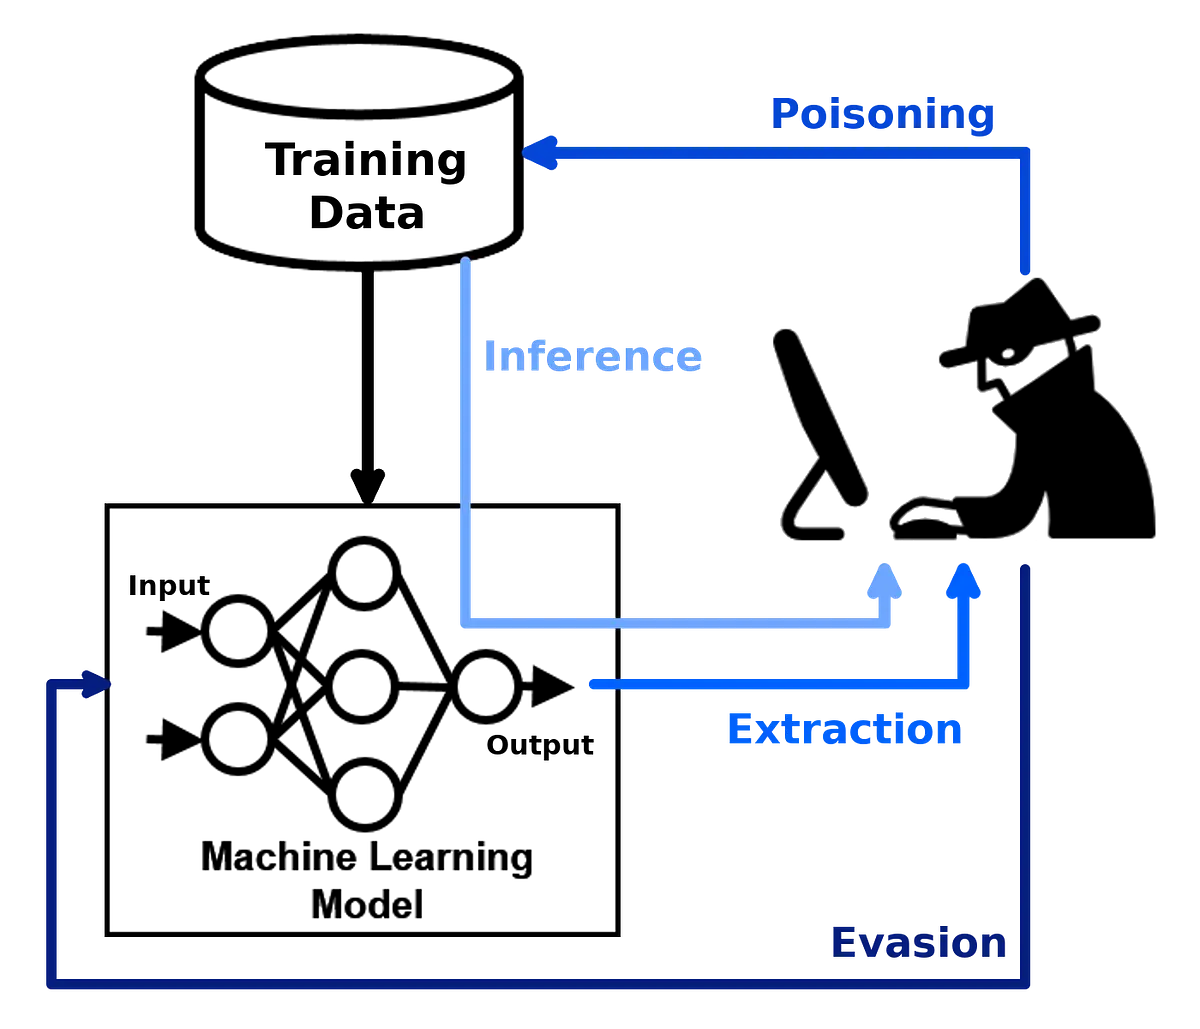
برای مقابله با مسمومسازی داده و کاهش تأثیرات آن بر مدلهای هوش مصنوعی، میتوان از روشهای مختلفی استفاده کرد. برخی از این روشها شامل:
- پاکسازی دادهها: یکی از مهمترین مراحل در آمادهسازی دادهها، پاکسازی آنها است. این فرآیند شامل شناسایی و حذف دادههای نادرست، تکراری یا نامرتبط است. استفاده از ابزارهای خودکار و الگوریتمهای تشخیص دادههای آلوده میتواند در این زمینه بسیار مؤثر باشد.
- توزیع عادلانه دادهها: اطمینان از این که دادههای آموزشی به صورت عادلانه و متناسب با جمعیت واقعی جمعآوری شدهاند، میتواند از ایجاد bias جلوگیری کند. برای مثال، در سیستمهای تشخیص چهره، باید دادههای مربوط به افراد با پوست تیره، زنان، و گروههای مختلف سنی به صورت برابر در مجموعه دادهها حضور داشته باشند.
- استفاده از روشهای تشخیص دادههای آلوده: استفاده از الگوریتمهای پیشرفته برای تشخیص دادههای آلوده میتواند کمک زیادی کند. این الگوریتمها میتوانند دادههای نادرست یا غیرمعمول را شناسایی و از آموزش مدل حذف کنند.
- تکرار آزمایشها: انجام آزمایشهای متعدد با دادههای مختلف میتواند کمک کند تا مدل در برابر مسمومسازی داده مقاومتر شود. این روش به ویژه در سیستمهای حساس مانند تشخیص بیماری یا پیشبینی بازارهای مالی بسیار مهم است.
- استفاده از دادههای واقعی و بهروزرسانی مداوم: استفاده از دادههای واقعی و بهروزرسانی مداوم مجموعه دادهها میتواند از مسمومسازی داده جلوگیری کند. دادههای قدیمی یا غیرمعتبر باید به صورت منظم بررسی و بهروزرسانی شوند.
- استفاده از روشهای فدرال لرنینگ: در سیستمهای فدرال لرنینگ، مدل در دستگاههای مختلف آموزش میبیند و دادهها در سرور مرکزی جمعآوری نمیشوند. این روش میتواند از مسمومسازی داده در سطح مرکزی جلوگیری کند.
همچنین، استفاده از روشهای مختلف ارزیابی مدل مانند cross-validation (تایید متقاطع) و تست با دادههای واقعی میتواند کمک کند تا مدل در برابر مسمومسازی داده مقاومتر شود.
نتیجهگیری و راهکارهای عملی
مسمومسازی داده یکی از چالشهای اصلی در توسعه و آموزش مدلهای هوش مصنوعی است. این پدیده میتواند به صورت عمدی یا غیرعمدی رخ دهد و تأثیرات جدی بر دقت و عملکرد مدل داشته باشد. برای مقابله با این مشکل، باید به پاکسازی دادهها، توزیع عادلانه آنها، استفاده از روشهای تشخیص دادههای آلوده، و بهروزرسانی مداوم مجموعه دادهها توجه ویژهای داشت.
در دنیای امروزی که هوش مصنوعی در بسیاری از زمینهها از جمله پزشکی، مالی، و حمل و نقل استفاده میشود، اهمیت دادههای باکیفیت و سالم بیش از پیش احساس میشود. با توجه به این که مسمومسازی داده میتواند منجر به تصمیمگیریهای نادرست و خطرناک شود، لازم است که توسعهدهندگان، محققان، و سازمانها به این موضوع توجه ویژهای داشته باشند.
برای اطلاعات بیشتر در مورد چالشهای مرتبط با دادهها و هوش مصنوعی، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید. این مقالات میتوانند راهنماییهای عملی برای بهبود کیفیت دادهها و افزایش دقت مدلهای هوش مصنوعی ارائه دهند.