تقلب مالی یکی از بزرگترین چالشهای سازمانها، بانکها و حتی دولتها در دنیای امروزی است. با پیشرفت فناوری و افزایش حجم دادهها، روشهای سنتی تشخیص تقلب دیگر کافی نیستند. در اینجا یادگیری ماشین به عنوان ابزاری قدرتمند وارد میشود تا با تحلیل الگوها و رفتارهای غیرعادی، تقلبها را با دقت بالایی شناسایی کند. اما چگونه این فرآیند دقیقاً انجام میشود؟ در این راهنما کامل، به بررسی مراحل تشخیص تقلب مالی با استفاده از یادگیری ماشین میپردازیم و نشان میدهیم که چگونه سازمانها میتوانند از این فناوری برای محافظت از داراییها و مشتریان خود استفاده کنند.
چرا تشخیص تقلب مالی اهمیت دارد؟
تقلب مالی نه تنها باعث زیان مالی مستقیم میشود، بلکه میتواند به آسیب به شهرت سازمان، از دست دادن اعتماد مشتریان و حتی مشکلات قانونی منجر شود. بر اساس گزارشهای بینالمللی، میزان زیانهای مالی ناشی از تقلب هر ساله میلیاردها دلار است و این رقم در حال افزایش است. بنابراین، استفاده از روشهای پیشرفته مانند یادگیری ماشین برای شناسایی سریع و دقیق تقلبها ضروری شده است.
یادگیری ماشین با تحلیل حجم عظیم دادهها و شناسایی الگوهای غیرطبیعی، میتواند به سازمانها کمک کند تا در زمان واقعی یا با تأخیر بسیار کم، فعالیتهای مشکوک را شناسایی و بررسی کنند. این فناوری نه تنها کارایی تشخیص را افزایش میدهد، بلکه هزینههای مرتبط با بررسی دستی تقلبها را نیز کاهش میدهد.
مراحل تشخیص تقلب مالی با یادگیری ماشین
فرآیند تشخیص تقلب مالی با استفاده از یادگیری ماشین شامل چندین مرحله کلیدی است که باید به درستی پیادهسازی شوند. در ادامه به بررسی این مراحل میپردازیم:
۱. جمعآوری و آمادهسازی دادهها
اولین و مهمترین مرحله در هر پروژه یادگیری ماشین، جمعآوری دادههای مناسب است. برای تشخیص تقلب مالی، دادههای مربوط به تراکنشها، رفتار مشتریان، اطلاعات حسابها و حتی دادههای خارجی مانند گزارشهای مالی و فعالیتهای بازار باید گردآوری شوند.
اما جمعآوری داده تنها بخشی از کار است. دادهها باید تمیز، کامل و ساختارمند باشند. این مرحله شامل پاکسازی دادهها (مانند حذف دادههای تکراری یا نادرست)، تکمیل دادههای ناقص و تبدیل دادهها به فرمت مناسب برای مدلهای یادگیری ماشین میشود.
در این مرحله، ویژگیهای مهمی مانند مقدار تراکنش، زمان انجام تراکنش، مکان جغرافیایی، تاریخچه فعالیت مشتری و حتی رفتارهای غیرمعمول باید شناسایی و استخراج شوند. این ویژگیها به مدل کمک میکنند تا الگوها و رفتارهای مشکوک را تشخیص دهد.
۲. انتخاب الگوریتم مناسب
پس از آمادهسازی دادهها، مرحله بعدی انتخاب الگوریتم یادگیری ماشین مناسب برای تشخیص تقلب است. الگوریتمهای مختلفی برای این منظور استفاده میشوند که هر کدام مزایا و معایب خاص خود را دارند.
برخی از الگوریتمهای رایج در تشخیص تقلب مالی عبارتند از:
- الگوریتمهای مبتنی بر درخت تصمیم (Decision Trees): این الگوریتمها با تقسیم دادهها به گروههای کوچکتر و تحلیل ویژگیهای هر گروه، میتوانند رفتارهای غیرمعمول را شناسایی کنند.
- شبکههای عصبی مصنوعی (Artificial Neural Networks – ANN): این شبکهها با شبیهسازی عملکرد مغز انسان، میتوانند الگوها و روابط پیچیده در دادهها را تشخیص دهند و برای دادههای بزرگ و پیچیده بسیار مؤثر هستند.
- الگوریتمهای خوشهبندی (Clustering): این روشها دادهها را به گروههای مشابه تقسیم میکنند و گروههایی که رفتار غیرمعمول دارند را شناسایی میکنند.
- الگوریتمهای مبتنی بر یادگیری عمیق (Deep Learning): برای دادههای بسیار بزرگ و پیچیده، مدلهای یادگیری عمیق مانند خودکارهای بازگشتی (RNN) یا شبکههای عصبی پیچشی (CNN) میتوانند نتایج بسیار دقیقتری ارائه دهند.
- الگوریتمهای مبتنی بر یادگیری تقویتی (Reinforcement Learning): این الگوریتمها میتوانند با یادگیری از تجربه، سیاستهای بهینهای برای تشخیص تقلب در زمان واقعی ارائه دهند.
انتخاب الگوریتم مناسب بستگی به حجم دادهها، پیچیدگی الگوها و نیازهای سازمان دارد. برای مثال، اگر دادهها بسیار بزرگ باشند، استفاده از الگوریتمهای یادگیری عمیق ممکن است بهترین انتخاب باشد، اما برای دادههای کوچکتر و سادهتر، الگوریتمهای مبتنی بر درخت تصمیم یا خوشهبندی میتوانند کارآمدتر باشند.
۳. آموزش مدل
پس از انتخاب الگوریتم، مدل باید با دادههای آموزشی آموزش داده شود. دادههای آموزشی باید شامل نمونههای تقلب و غیرتقلب باشند تا مدل بتواند تفاوت بین این دو را یاد بگیرد.
در این مرحله، دادهها به دو بخش تقسیم میشوند: دادههای آموزشی و دادههای تست. مدل با استفاده از دادههای آموزشی آموزش میبیند و سپس با دادههای تست ارزیابی میشود تا دقت و کارایی آن اندازهگیری شود.
یکی از چالشهای اصلی در آموزش مدل، عدم تعادل دادهها است. در بسیاری از موارد، تعداد نمونههای تقلب بسیار کمتر از نمونههای غیرتقلب است. این عدم تعادل میتواند باعث شود که مدل به جای تشخیص تقلب، بیشتر به تشخیص تراکنشهای عادی تمرکز کند. برای حل این مشکل، روشهایی مانند نمونهبرداری مجدد (Resampling)، استفاده از تکنیکهای افزایش داده (Data Augmentation) یا استفاده از تابع هزینه غیرمتوازن (Imbalanced Cost Function) میتوانند کمک کنند.
۴. ارزیابی و بهینهسازی مدل
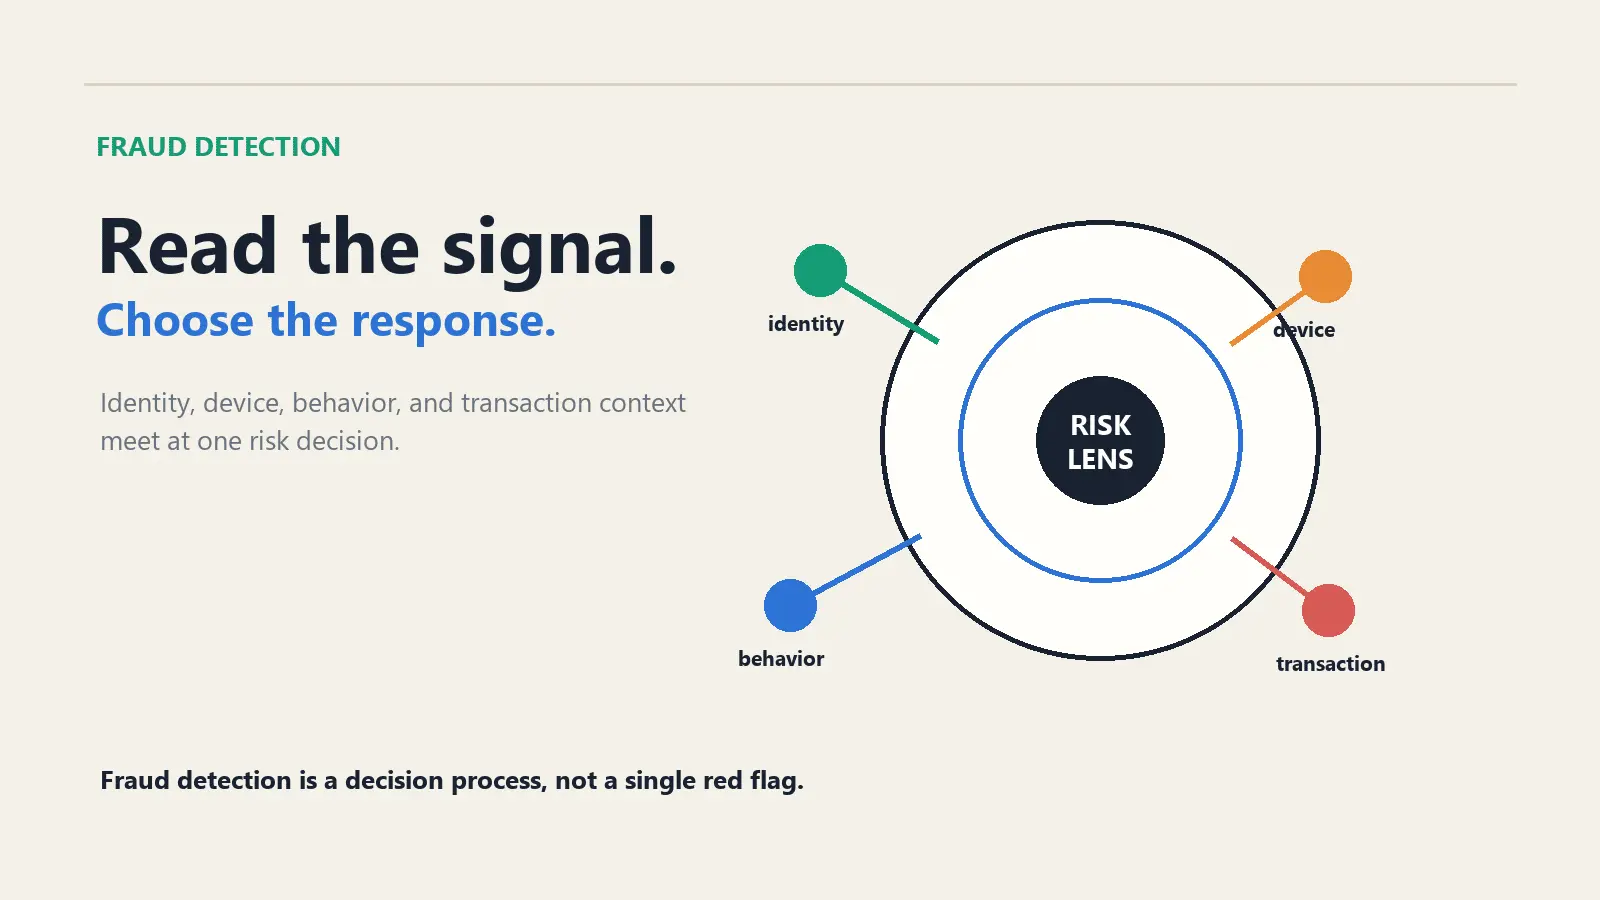
پس از آموزش مدل، مرحله بعدی ارزیابی عملکرد آن است. برای ارزیابی مدل، متریکهای مختلفی مانند دقت (Accuracy)، حساسیت (Sensitivity)، خاصیت (Specificity)، F1-score و ماتریس اشتباه (Confusion Matrix) استفاده میشوند.
متریکهای مختلف برای سناریوهای مختلف مناسب هستند. برای مثال، در تشخیص تقلب مالی، حساسیت بسیار مهم است زیرا باید اطمینان حاصل شود که تعداد کمی از تقلبها بدون شناسایی باقی نمانند. اما در عین حال، باید از تعداد کاذب مثبت (False Positives) نیز جلوگیری کرد، زیرا این موارد میتوانند باعث ایجاد آزار و اذیت برای مشتریان شوند.
پس از ارزیابی اولیه، مدل باید بهینهسازی شود. این بهینهسازی میتواند شامل تنظیم پارامترهای الگوریتم، استفاده از دادههای بیشتری برای آموزش، یا حتی تغییر الگوریتم باشد. هدف نهایی دستیابی به مدل با دقت بالا و تعداد کاذب مثبت کم است.
۵. پیادهسازی و نظارت بر مدل
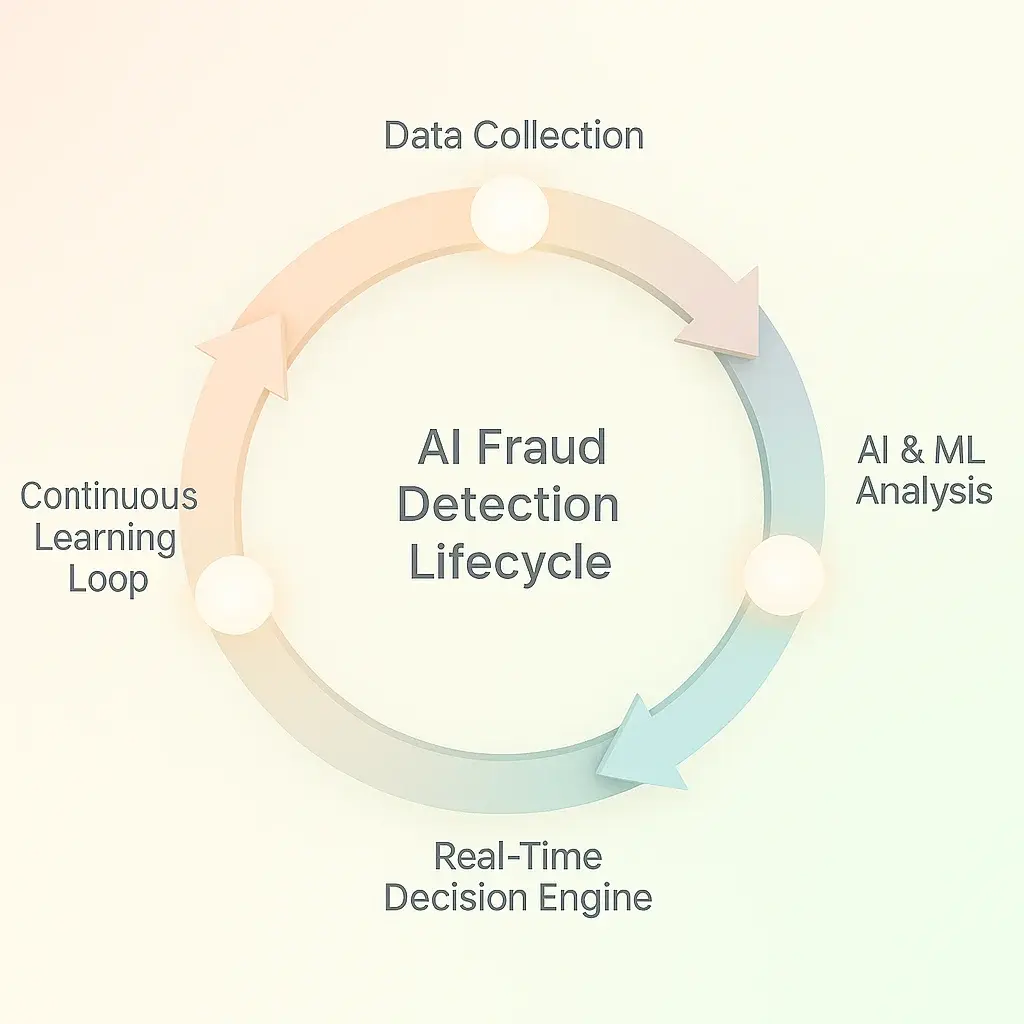
پس از آموزش و بهینهسازی مدل، مرحله بعدی پیادهسازی آن در محیط تولید است. این مرحله شامل ادغام مدل با سیستمهای موجود سازمان، مانند سیستمهای پرداخت، بانکداری الکترونیک یا سیستمهای حسابداری، میشود.
در این مرحله، مدل باید بتواند در زمان واقعی یا با تأخیر بسیار کم، تراکنشها را بررسی و فعالیتهای مشکوک را شناسایی کند. همچنین، سیستم باید قابلیت گزارشدهی و هشداردهی به مدیران یا تیمهای امنیتی را داشته باشد.
نظارت مستمر بر عملکرد مدل نیز بسیار مهم است. با تغییر الگوها و رفتارهای تقلبکاران، مدل باید بهطور مداوم بهروزرسانی شود. این بهروزرسانی میتواند شامل آموزش مجدد مدل با دادههای جدید یا تنظیم پارامترهای آن باشد.
چالشهای تشخیص تقلب مالی با یادگیری ماشین
در حالی که استفاده از یادگیری ماشین در تشخیص تقلب مالی مزایای بسیاری دارد، اما با چالشهایی نیز همراه است. برخی از این چالشها عبارتند از:
- عدم تعادل دادهها: همانطور که قبلاً اشاره شد، تعداد نمونههای تقلب معمولاً بسیار کمتر از نمونههای غیرتقلب است. این عدم تعادل میتواند باعث کاهش دقت مدل شود.
- پیچیدگی الگوها: تقلبکاران همیشه روشهای جدیدی برای فرار از سیستمهای تشخیص تقلب پیدا میکنند. بنابراین، مدل باید بتواند الگوها را بهطور مداوم یاد بگیرد و بهروزرسانی کند.
- نظارت و تفسیرپذیری: بسیاری از مدلهای یادگیری ماشین، به ویژه مدلهای یادگیری عمیق، مانند “جعبه سیاه” عمل میکنند و تفسیر نتایج آنها دشوار است. این موضوع میتواند برای سازمانها که نیاز به توضیح تصمیمات مدل دارند، چالشآفرین باشد.
- محدودیتهای فنی و هزینهها: پیادهسازی سیستمهای تشخیص تقلب با استفاده از یادگیری ماشین ممکن است نیاز به سرمایهگذاری در سختافزار و نرمافزار پیشرفته داشته باشد که برای برخی سازمانها هزینهبر است.
راهکارهای بهبود تشخیص تقلب مالی
برای غلبه بر چالشهای ذکر شده و بهبود کارایی سیستمهای تشخیص تقلب مالی، میتوان از راهکارهای زیر استفاده کرد:
- استفاده از دادههای خارجی: ترکیب دادههای داخلی سازمان با دادههای خارجی مانند گزارشهای مالی، فعالیتهای بازار و حتی دادههای اجتماعی میتواند کمک کند تا الگوها و رفتارهای جدیدی شناسایی شوند.
- بهروزرسانی مداوم مدل: با تغییر روشهای تقلب، مدل باید بهطور مداوم با دادههای جدید آموزش داده شود تا بتواند با روشهای جدید تقلب مقابله کند.
- استفاده از مدلهای تفسیرپذیر: مدلهای مبتنی بر درخت تصمیم یا روشهای مانند SHAP (SHapley Additive exPlanations) میتوانند کمک کنند تا تصمیمات مدل قابل تفسیرتر باشند و سازمانها بتوانند دلیل تصمیمات مدل را درک کنند.
- کمک گرفتن از متخصصان: همکاری با متخصصان حوزه مالی و امنیتی میتواند کمک کند تا مدلها بهتر طراحی و پیادهسازی شوند و نیازهای سازمان بهتر درک شوند.
- استفاده از روشهای ترکیبی: ترکیب چندین الگوریتم یا روش تشخیص تقلب میتواند دقت و کارایی سیستم را افزایش دهد. برای مثال، استفاده از روشهای مبتنی بر یادگیری ماشین در کنار تحلیل رفتاری میتواند نتایج بهتری ارائه دهد.
نکات مهم برای سازمانها
سازمانهایی که قصد دارند از یادگیری ماشین برای تشخیص تقلب مالی استفاده کنند، باید به نکات زیر توجه کنند:
- تعیین اهداف واضح: قبل از شروع پروژه، اهداف و نیازهای سازمان باید بهطور دقیق مشخص شوند. آیا هدف کاهش تعداد تقلبها است یا کاهش هزینههای مرتبط با بررسی دستی؟
- انتخاب تیم مناسب: تیم پروژه باید شامل متخصصان داده، برنامهنویسان، متخصصان مالی و حتی متخصصان امنیتی باشد.
- ارزیابی ریسک و مزایا: قبل از پیادهسازی، باید ریسکها و مزایای استفاده از یادگیری ماشین ارزیابی شوند. این شامل بررسی هزینهها، زمان پیادهسازی و تأثیر بر مشتریان است.
- نظارت و بهبود مستمر: سیستم تشخیص تقلب باید بهطور مداوم نظارت شود و بر اساس بازخوردها و تغییرات در الگوها بهروزرسانی شود.
استفاده از یادگیری ماشین در تشخیص تقلب مالی میتواند به سازمانها کمک کند تا با دقت و کارایی بیشتری فعالیتهای مشکوک را شناسایی و از زیانهای مالی جلوگیری کنند. با پیروی از مراحل و راهکارهای ذکر شده، سازمانها میتوانند سیستمهای تشخیص تقلب موثری را طراحی و پیادهسازی کنند.
برای اطلاعات بیشتر در مورد کاربردهای دیگر یادگیری ماشین در حوزههای مختلف، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید.