هوش مصنوعی در دهههای اخیر به یکی از سریعترین و تأثیرگذارترین زمینههای علمی و فنی تبدیل شده است. یکی از روشهای مهم یادگیری در هوش مصنوعی، یادگیری تقویتی (Reinforcement Learning) است که بر اساس تعامل بین یک عامل (agent) و محیط (environment) بنا شده و هدف آن یادگیری سیاستهایی است که به عامل کمک میکند تا در طول زمان پاداش بیشتری کسب کند. این روش در بسیاری از کاربردهای واقعی از جمله بازیهای ویدئویی، رباتیک، سیستمهای خودران و حتی مدیریت منابع به کار میرود. اما چگونه این روش کار میکند؟ چه تفاوتی با روشهای دیگر یادگیری ماشین دارد؟ و چرا یادگیری تقویتی در هوش مصنوعی به این اندازه مهم است؟ در این مقاله به بررسی جزئیات و نکات کلیدی یادگیری تقویتی و نحوه استفاده از آن در هوش مصنوعی میپردازیم.
یادگیری تقویتی چیست؟
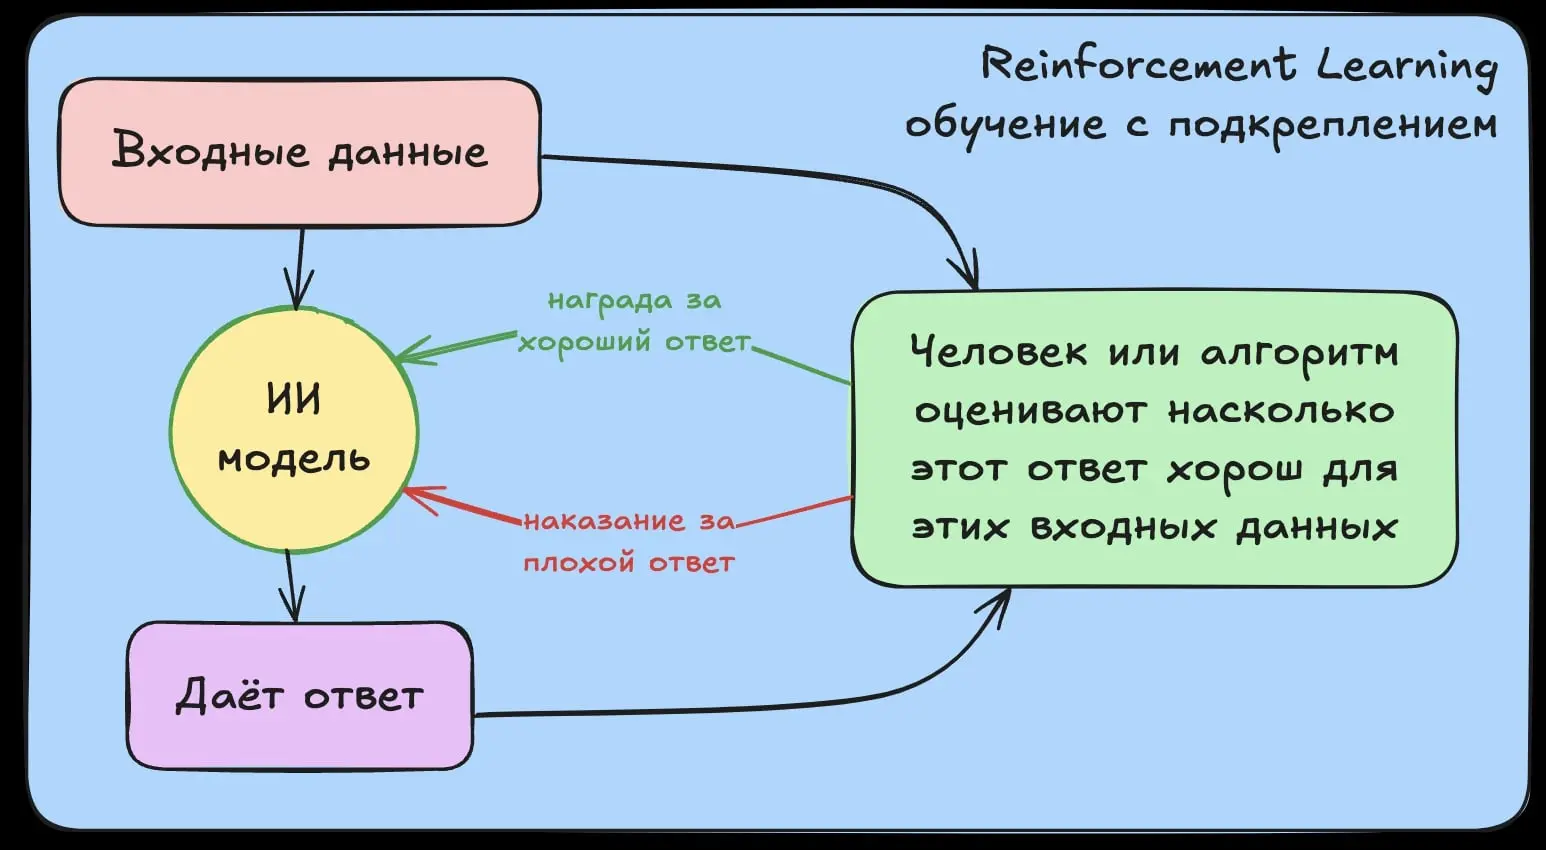
یادگیری تقویتی یک پارادایم یادگیری ماشین است که در آن یک عامل با محیط تعامل میکند و از طریق تجربه و دریافت پاداش یا جریمه، سیاستهای بهینه را یادمیگیرد. در این روش، عامل به دنبال یادگیری یک سیاست است که به او امکان میدهد در طول زمان بیشترین پاداش را کسب کند. این روش برخلاف یادگیری نظارتشده (Supervised Learning) که دادههای برچسبدار نیاز دارد، یا یادگیری بدون نظارت (Unsupervised Learning) که بر اساس کشف الگوها کار میکند، بر اساس تعامل مداوم با محیط و دریافت بازخورد از آن بنا شده است.
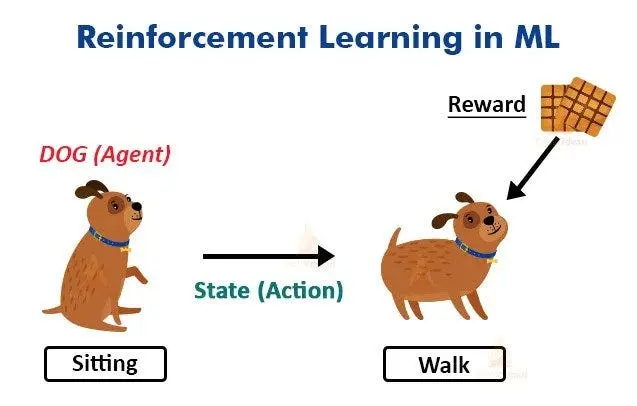
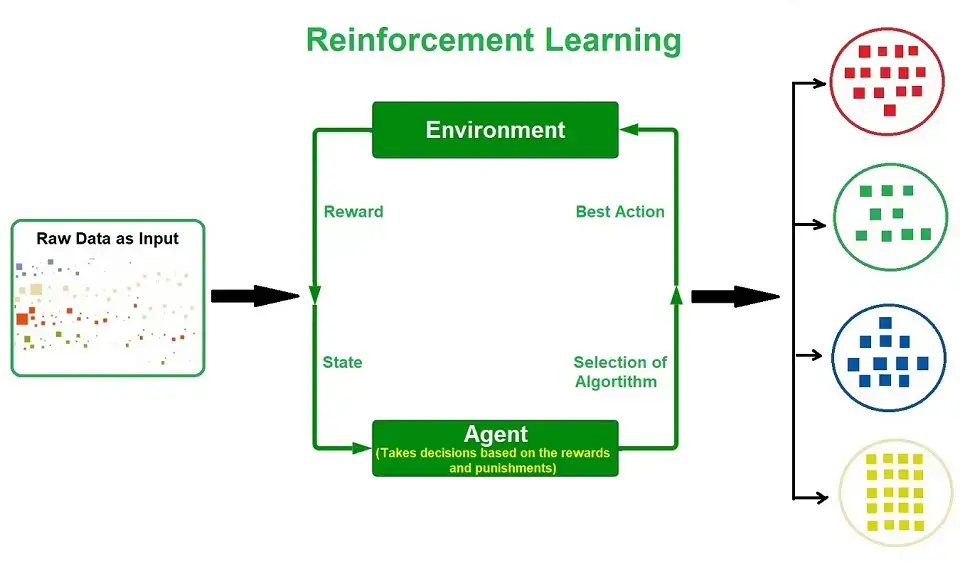
در یادگیری تقویتی، عامل در هر مرحله یک عمل (action) انجام میدهد و سپس بازخوردی در قالب پاداش (reward) دریافت میکند. این بازخورد میتواند مثبت (پاداش) یا منفی (جریمه) باشد و عامل با استفاده از این بازخوردها، سیاست خود را بهینه میکند. هدف نهایی، یادگیری یک سیاست است که به عامل اجازه میدهد در هر حالت، عمل بهینه را انتخاب کند.
عناصر اصلی یادگیری تقویتی
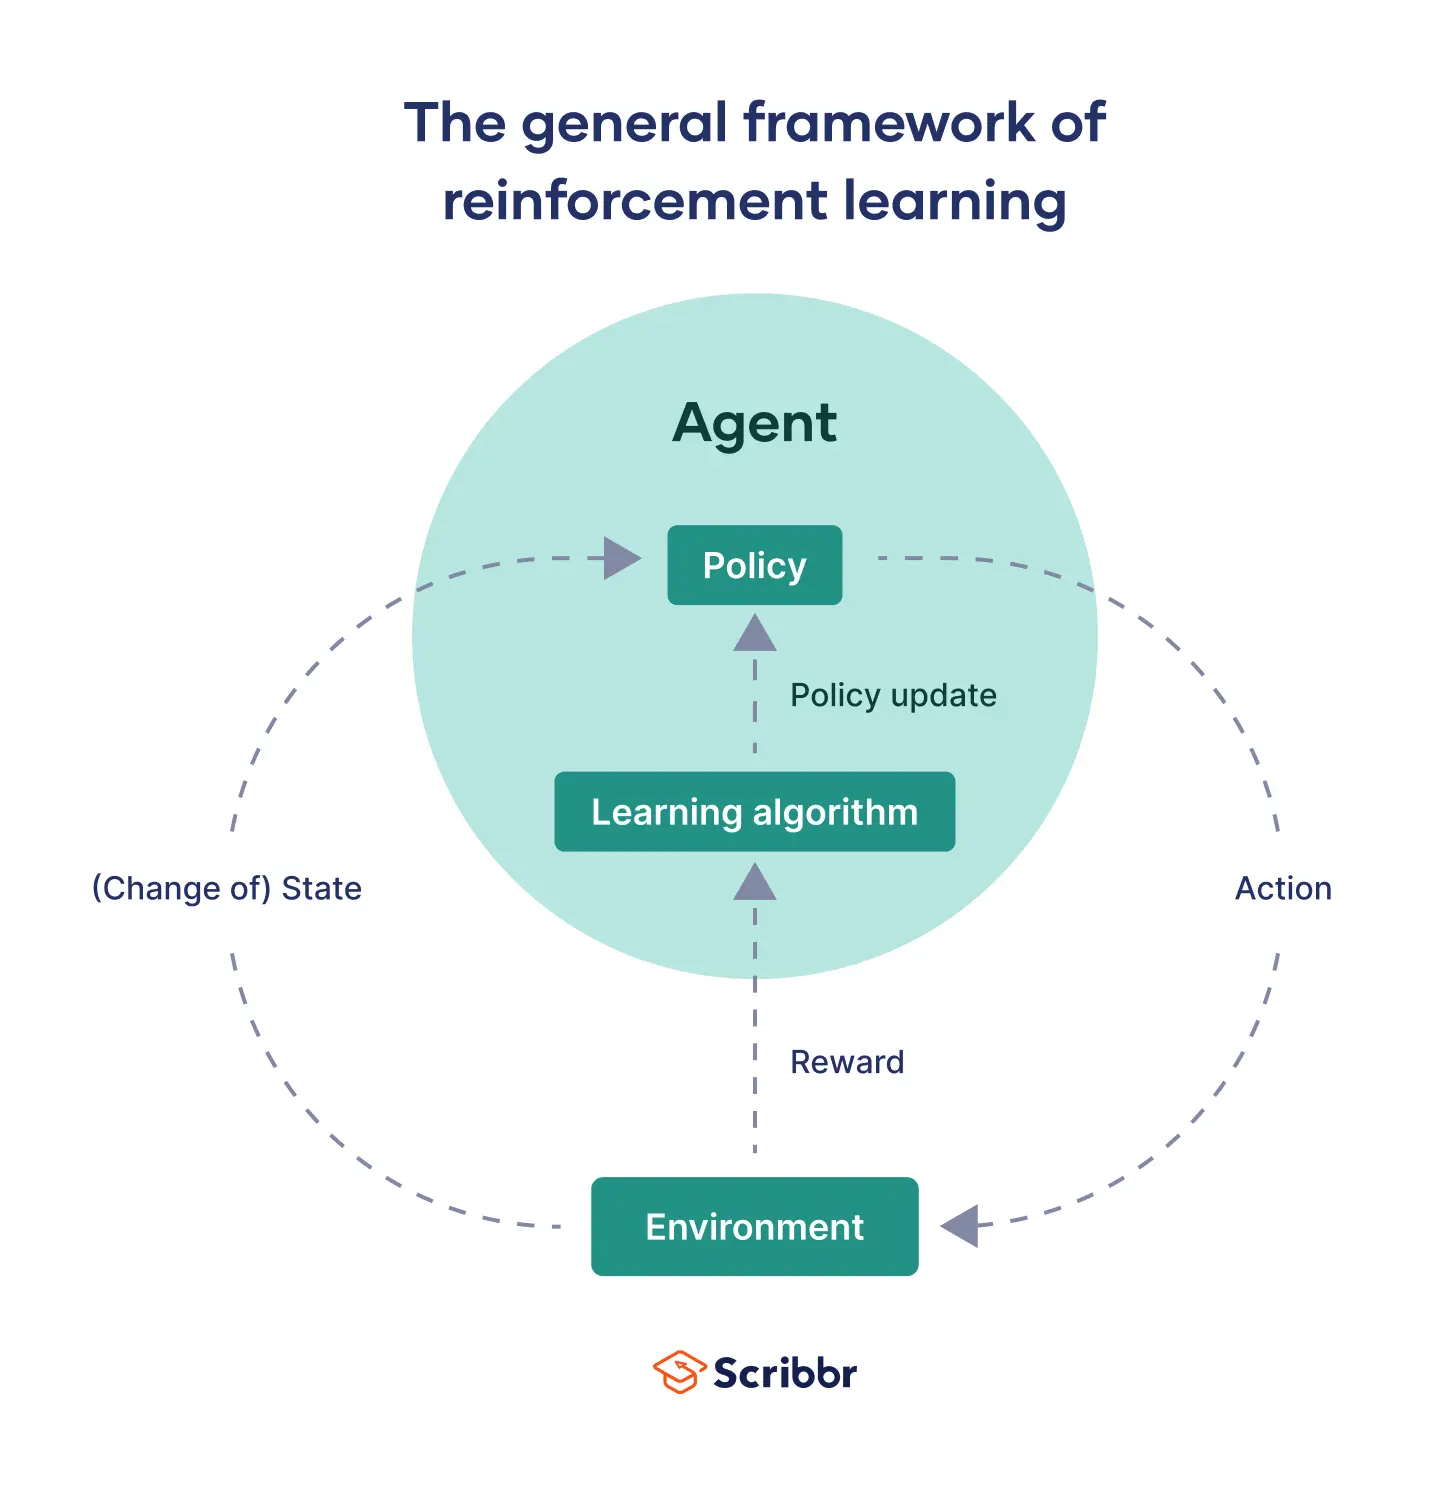
برای درک بهتر نحوه کارکرد یادگیری تقویتی، باید با عناصر اصلی آن آشنا شوید:
- عامل (Agent): این بخش از سیستم هوش مصنوعی است که تصمیمات را میگیرد و اقدامات را انجام میدهد. عامل میتواند یک الگوریتم، ربات یا حتی یک برنامه کامپیوتری باشد.
- محیط (Environment): محیطی که عامل در آن عمل میکند و با آن تعامل دارد. محیط میتواند فیزیکی (مانند یک ربات در یک فضا) یا مجازی (مانند یک بازی ویدئویی) باشد.
- حالت (State): توصیف کننده وضعیت فعلی محیط است. حالت میتواند شامل اطلاعاتی مانند موقعیت ربات، وضعیت بازی یا هر پارامتری باشد که وضعیت سیستم را مشخص میکند.
- عمل (Action): اقداماتی که عامل میتواند در هر حالت انجام دهد. این اقدامات میتوانند شامل حرکت، انتخاب یک گزینه یا هر عمل دیگری باشند.
- پاداش (Reward): بازخوردی که عامل از محیط دریافت میکند. پاداش میتواند مثبت (برای اقدامات موفق) یا منفی (برای اقدامات ناموفق) باشد و هدف عامل کسب بیشترین پاداش در طول زمان است.
- سیاست (Policy): یک تابع است که به عامل میگوید در هر حالت چه عمل انجام دهد. سیاست میتواند تصادفی، تعیینشده یا یادگرفتهشده باشد.
این عناصر در یک چرخه مداوم با یکدیگر تعامل دارند و عامل با استفاده از تجربیات گذشته، سیاست خود را بهینه میکند.
تفاوت یادگیری تقویتی با سایر روشهای یادگیری ماشین
یادگیری تقویتی با روشهای دیگر یادگیری ماشین مانند یادگیری نظارتشده و بدون نظارت تفاوتهای اساسی دارد:
- یادگیری نظارتشده: در این روش، مدل با دادههای برچسبدار آموزش میبیند. برای مثال، یک شبکه عصبی میتواند با تصاویر برچسبدار آموزش ببیند که چگونه اشیا را تشخیص دهد. اما در یادگیری تقویتی، مدل از طریق تعامل با محیط و دریافت پاداش یادمیگیرد.
- یادگیری بدون نظارت: در این روش، مدل بدون دادههای برچسبدار، الگوها و ساختارهای داده را کشف میکند. اما یادگیری تقویتی بر اساس تعامل فعال با محیط و دریافت بازخورد است.
- یادگیری تقویتی: در این روش، عامل با انجام اقدامات و دریافت پاداش، سیاست خود را بهینه میکند. این روش به ویژه در شرایطی که دادههای برچسبدار در دسترس نیست یا تعامل با محیط امکانپذیر است، بسیار مؤثر است.
یادگیری تقویتی به ویژه در شرایطی که محیط پیچیده است و دادههای برچسبدار در دسترس نیست، بسیار مفید است. برای مثال، در آموزش یک ربات برای حرکت در یک محیط ناشناخته، استفاده از یادگیری تقویتی بسیار مناسبتر از روشهای دیگر است.
چگونه هوش مصنوعی از پاداش و خطا یادمیگیرد؟
یکی از نکات کلیدی در یادگیری تقویتی، نحوه استفاده از پاداش و جریمه برای آموزش عامل است. عامل با انجام اقدامات مختلف و دریافت پاداش یا جریمه، سیاست خود را بهینه میکند. این فرآیند به دو روش اصلی انجام میشود:
- یادگیری با مدل (Model-Based Learning): در این روش، عامل یک مدل از محیط یادمیگیرد و سپس با استفاده از این مدل، سیاست خود را بهینه میکند. این روش به ویژه در محیطهایی که مدل قابل پیشبینی است، مؤثر است.
- یادگیری بدون مدل (Model-Free Learning): در این روش، عامل بدون استفاده از مدل محیط، سیاست خود را بهینه میکند. این روش به ویژه در محیطهایی که مدل پیچیده یا ناشناخته است، استفاده میشود.
در یادگیری بدون مدل، دو روش اصلی وجود دارد:
- یادگیری ارزش (Value-Based Learning): در این روش، عامل ارزش هر حالت یا عمل را یادمیگیرد و سپس اقداماتی را انتخاب میکند که ارزش بیشتری دارند.
- یادگیری سیاست (Policy-Based Learning): در این روش، عامل سیاست خود را بهطور مستقیم بهینه میکند، یعنی یادمیگیرد که در هر حالت چه عمل انجام دهد.
یکی از روشهای معروف یادگیری ارزش، الگوریتم Q-Learning است که در آن عامل ارزش هر عمل در هر حالت را یادمیگیرد و سپس اقداماتی را انتخاب میکند که ارزش بیشتری دارند. در این روش، عامل یک جدول Q دارد که ارزش هر عمل در هر حالت را ذخیره میکند و با بهروزرسانی این جدول، سیاست خود را بهینه میکند.
در یادگیری سیاست، عامل سیاست خود را بهطور مستقیم بهینه میکند. برای مثال، در روشهای مبتنی بر شبکه عصبی، سیاست میتواند یک تابع باشد که با استفاده از شبکه عصبی، عمل بهینه را در هر حالت انتخاب میکند.
چالشهای یادگیری تقویتی
در حالی که یادگیری تقویتی بسیار قدرتمند است، اما با چالشهایی نیز همراه است:
- پробلم جستجو (Search Problem): در محیطهای بزرگ و پیچیده، جستجوی سیاست بهینه میتواند بسیار زمانبر و محاسباتی باشد.
- پاداش ناپایدار (Sparse Rewards): در برخی محیطها، پاداش تنها در پایان یک سری اقدامات داده میشود که این موضوع یادگیری را دشوار میکند.
- پاداش تأخیردار (Delayed Rewards): در برخی موارد، پاداش با تأخیر داده میشود که این موضوع یادگیری سیاست بهینه را پیچیده میکند.
- پاداش تصادفی (Stochastic Rewards): در محیطهایی که پاداش تصادفی است، یادگیری سیاست بهینه بسیار دشوار است.
- پاداش منفی (Negative Rewards): در برخی موارد، عامل ممکن است به دلیل دریافت پاداش منفی، از انجام اقدامات مفید خودداری کند.
برای حل این چالشها، روشهای مختلفی مانند استفاده از حافظه، الگوریتمهای بهینهسازی پیشرفته و مدلهای پیچیدهتر پیشنهاد شده است.
کاربردهای یادگیری تقویتی در هوش مصنوعی
یادگیری تقویتی در بسیاری از زمینهها کاربرد دارد. برخی از مهمترین کاربردها عبارتند از:
- بازیهای ویدئویی: الگوریتمهای یادگیری تقویتی مانند AlphaGo و DQN توانستهاند در بازیهای پیچیده مانند گو و اتاری به نتایج قابل توجهی دست یابند.
- رباتیک: رباتها میتوانند با استفاده از یادگیری تقویتی، مهارتهای مختلفی مانند حرکت، گرفتن اشیا و навіگیشن را یادبگیرند.
- سیستمهای خودران: خودروهای خودران میتوانند با استفاده از یادگیری تقویتی، تصمیمات بهینه را در شرایط مختلف ترافیکی بگیرند.
- مدیریت منابع: در سیستمهای مدیریت منابع مانند شبکههای برق، یادگیری تقویتی میتواند به بهینهسازی مصرف انرژی کمک کند.
- پلتفرمهای توصیه: سیستمهای توصیه مانند پلتفرمهای خرید آنلاین میتوانند با استفاده از یادگیری تقویتی، پیشنهادات بهتری به کاربران ارائه دهند.
یادگیری تقویتی همچنین در زمینههای دیگری مانند پزشکی، مالی و حتی هنر کاربرد دارد. برای مثال، در پزشکی، میتوان از این روش برای بهینهسازی درمانهای پزشکی استفاده کرد.
نکات مهم در یادگیری تقویتی
برای استفاده مؤثر از یادگیری تقویتی، باید به نکات زیر توجه کرد:
- تعریف صحیح پاداش: پاداش باید بهطور دقیق تعریف شود تا عامل بتواند سیاست بهینه را یادبگیرد. پاداش باید با هدف نهایی هماهنگ باشد.
- انتخاب الگوریتم مناسب: انتخاب الگوریتم مناسب بر اساس پیچیدگی محیط و نوع مسئله بسیار مهم است. برای مثال، در محیطهای کوچک، الگوریتمهای سادهتر مانند Q-Learning کافی هستند، اما در محیطهای بزرگتر، الگوریتمهای پیچیدهتر مانند Deep Q-Networks (DQN) یا Policy Gradient Methods استفاده میشوند.
- مدلسازی محیط: اگر محیط قابل مدلسازی است، استفاده از روشهای مبتنی بر مدل میتواند بسیار مؤثر باشد.
- بهینهسازی سیاست: سیاست باید بهطور مداوم بهینه شود تا عامل بتواند در شرایط مختلف عملکرد بهتری داشته باشد.
- ارزیابی عملکرد: ارزیابی مداوم عملکرد عامل با استفاده از متریکهای مناسب مانند مجموع پاداش، تعداد اقدامات موفق و غیره بسیار مهم است.
یادگیری تقویتی یک روش قدرتمند در هوش مصنوعی است که با استفاده از تعامل با محیط و دریافت پاداش، سیاستهای بهینه را یادمیگیرد. این روش در بسیاری از کاربردهای واقعی از جمله بازیهای ویدئویی، رباتیک و سیستمهای خودران استفاده میشود. با درک عناصر اصلی، چالشها و کاربردهای این روش، میتوان از آن برای حل مشکلات پیچیده استفاده کرد.
اگر به دنبال اطلاعات بیشتر در مورد روشهای مختلف یادگیری ماشین و هوش مصنوعی هستید، میتوانید در تایم به تایم مقالات مفید دیگری را مطالعه کنید.