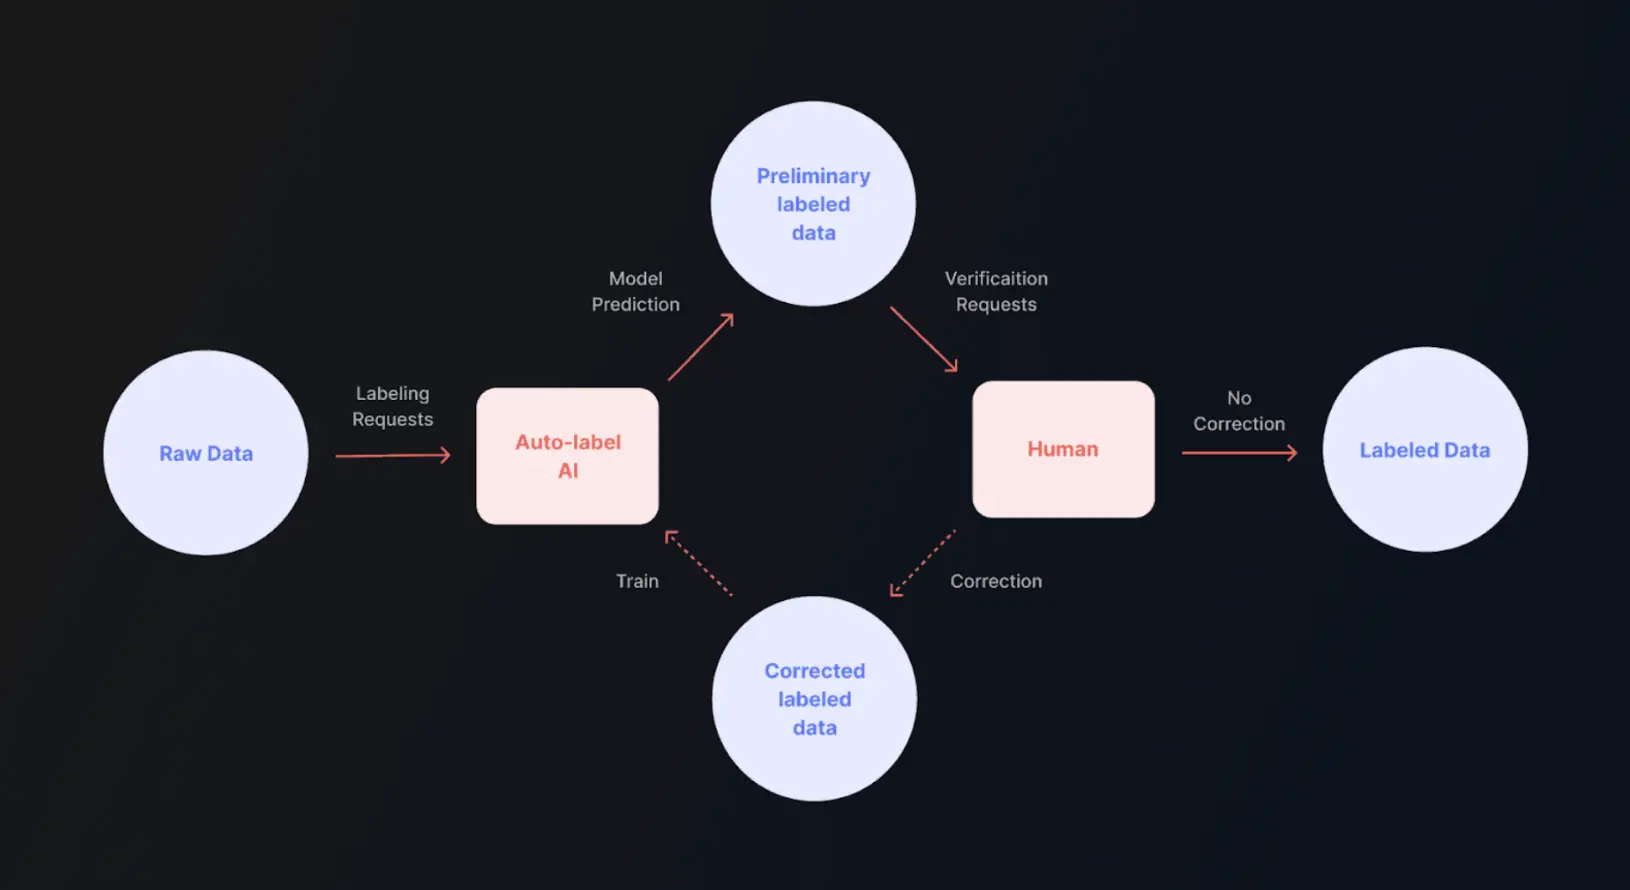
در دنیای امروزی که هوش مصنوعی به یکی از مهمترین ابزارهای تحول در صنایع مختلف تبدیل شده است، دادهها نقش اساسی در عملکرد و دقت سیستمهای هوش مصنوعی دارند. اما دادههای خام به تنهایی کافی نیستند؛ برای آموزش مدلهای هوش مصنوعی، نیاز به دادههایی است که به درستی برچسبگذاری شده باشند. این دادهها به مدلها کمک میکنند تا الگوها، روابط و معانی را تشخیص دهند و تصمیمات هوشمندانه بگیرند. اما داده برچسبگذاریشده دقیقاً چیست و چرا برای آموزش هوش مصنوعی اینقدر حیاتی است؟ در این راهنما کامل، به بررسی این موضوع میپردازیم و نکات کاربردی را برای درک بهتر این مفهوم ارائه میدهیم.
داده برچسبگذاریشده چیست؟
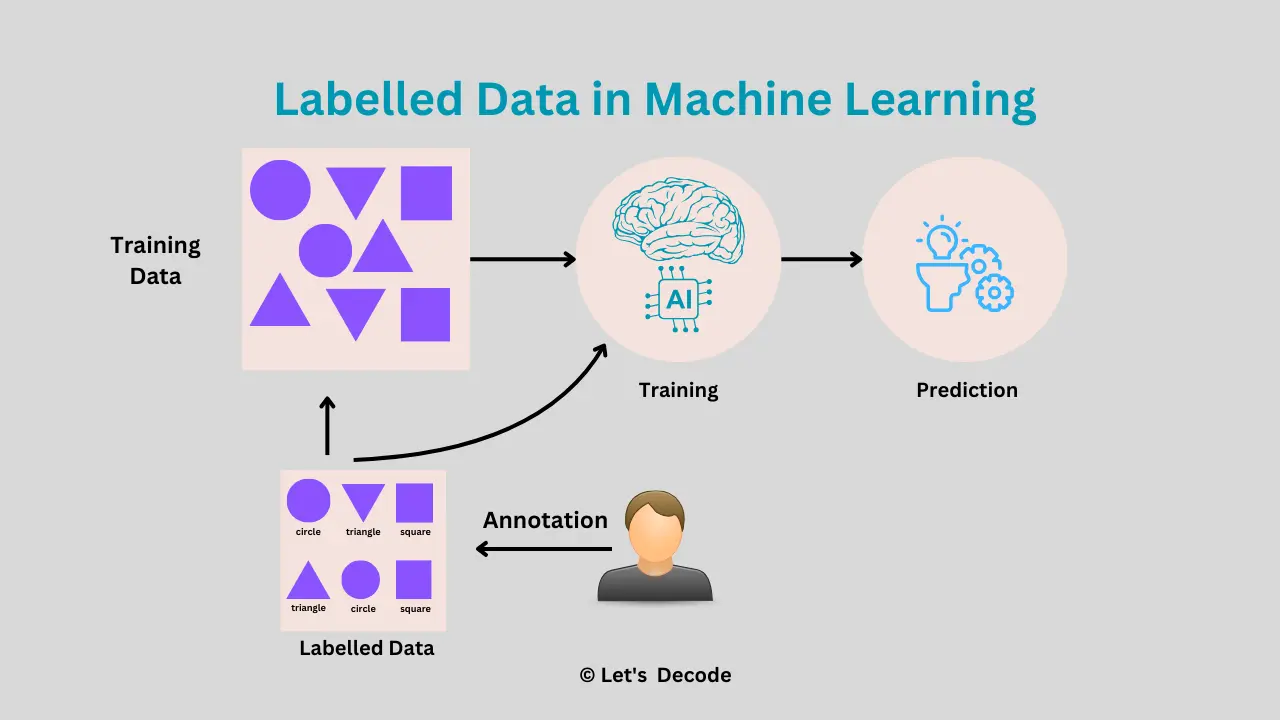
داده برچسبگذاریشده به مجموعهای از دادهها گفته میشود که علاوه بر اطلاعات اصلی، دارای برچسب یا متادیتاهایی هستند که به مدل هوش مصنوعی کمک میکنند تا داده را درک و طبقهبندی کند. برای مثال، در یک مجموعه داده تصاویر، هر تصویر ممکن است با برچسبهایی مانند “گربه”، “سگ”، یا “پروانه” همراه باشد. این برچسبها به مدل آموزش میدهند که چگونه باید تصاویر مختلف را تشخیص دهد.
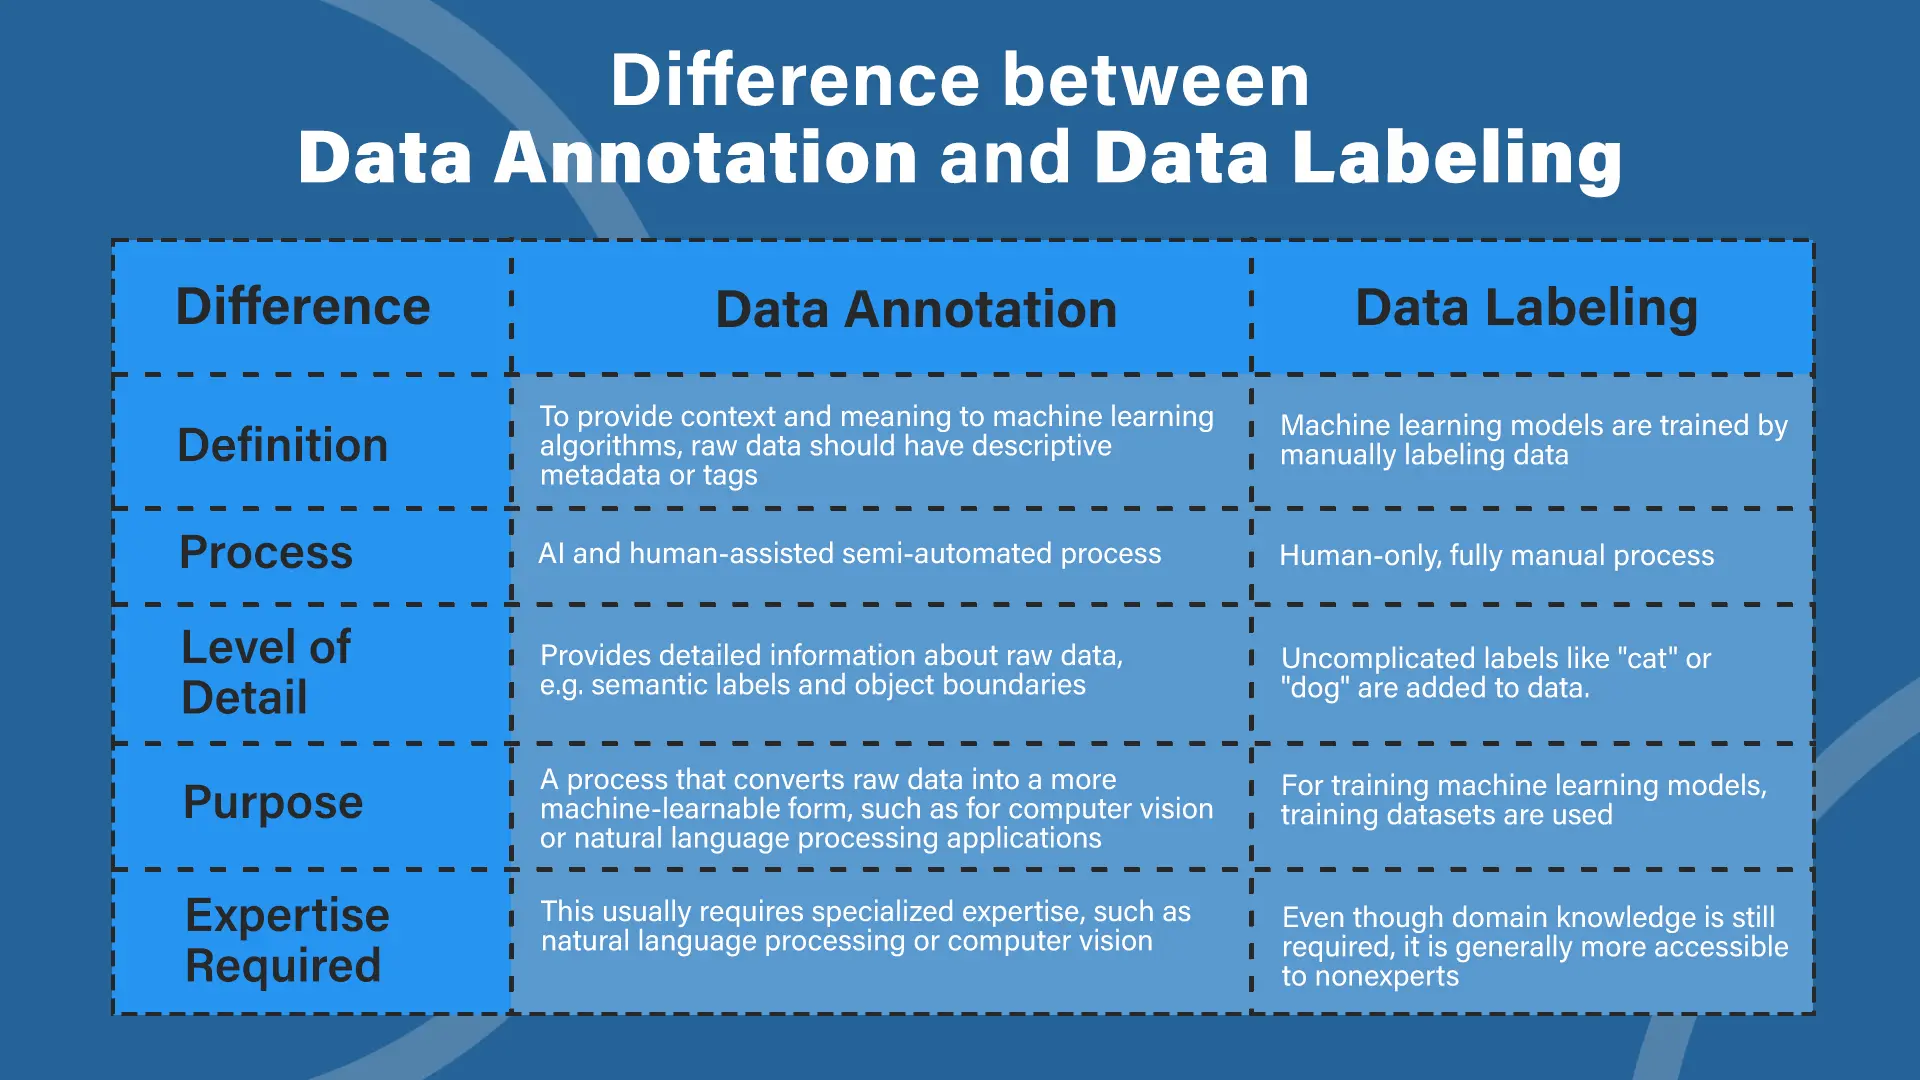
برچسبگذاری میتواند به صورت دستی توسط انسانها انجام شود یا با استفاده از روشهای خودکار و نیمه خودکار. در بسیاری از موارد، برچسبگذاری دستی دقیقتر است، اما زمانبر و هزینهبر میباشد. از سوی دیگر، روشهای خودکار مانند استفاده از الگوریتمهای یادگیری ماشین میتوانند سرعت برچسبگذاری را افزایش دهند، اما ممکن است دقت کمتری داشته باشند.
در واقع، داده برچسبگذاریشده مانند یک کتاب آموزش برای هوش مصنوعی عمل میکند. بدون این برچسبها، مدل نمیتواند تفاوت بین دادههای مختلف را درک کند و نمیتواند به درستی آموزش ببیند.
چرا داده برچسبگذاریشده برای آموزش هوش مصنوعی اهمیت دارد؟
اهمیت داده برچسبگذاریشده در آموزش هوش مصنوعی از چند جهت قابل بررسی است:
- دقت بالا: مدلهای هوش مصنوعی برای ارائه نتایج دقیق نیاز به دادههای برچسبگذاریشده دارند. بدون برچسبها، مدل نمیتواند تفاوت بین دادههای مختلف را تشخیص دهد و ممکن است نتایج نادرست ارائه دهد.
- یادگیری سوپرایز: یکی از روشهای اصلی آموزش هوش مصنوعی، یادگیری سوپرایز است که به این معنی است که مدل باید بر اساس دادههای برچسبگذاریشده یاد بگیرد. این روش به مدل کمک میکند تا الگوها و روابط بین دادهها را شناسایی کند.
- کارایی و عملکرد: دادههای برچسبگذاریشده به مدل اجازه میدهند تا بهتر عمومیسازی کند و در دادههای جدید نیز عملکرد خوبی داشته باشد. این موضوع به ویژه در کاربردهای حساس مانند تشخیص بیماریها یا تشخیص چهره بسیار مهم است.
- بهینهسازی مدل: با استفاده از دادههای برچسبگذاریشده، میتوان مدل را بهتر تنظیم کرد و پارامترهای آن را بهینهسازی نمود. این کار باعث میشود مدل سریعتر و دقیقتر عمل کند.
به عنوان مثال، در یک سیستم تشخیص خودکار تصاویر پزشکی، دادههای برچسبگذاریشده شامل تصاویر اسکنهای پزشکی همراه با تشخیص پزشکان هستند. این دادهها به مدل کمک میکنند تا بیماریها را با دقت بیشتری تشخیص دهد.
چگونه دادههای برچسبگذاریشده را تهیه کنیم؟
تهیه دادههای برچسبگذاریشده یک فرآیند چند مرحلهای است که نیاز به دقت و توجه دارد. در این بخش، به برخی از روشهای اصلی تهیه این دادهها میپردازیم:
برچسبگذاری دستی
در این روش، افراد متخصص یا کاربران با استفاده از ابزارهای خاص، دادهها را برچسبگذاری میکنند. این روش دقیق است، اما زمانبر و هزینهبر میباشد. برای مثال، در پروژههای تشخیص تصویر، افراد ممکن است هر تصویر را با برچسب مناسب همراه کنند.
برچسبگذاری نیمه خودکار
در این روش، از الگوریتمهای هوش مصنوعی برای پیشبرچسبگذاری دادهها استفاده میشود و سپس افراد متخصص برچسبها را تصحیح میکنند. این روش سرعت بیشتری نسبت به برچسبگذاری دستی دارد و در عین حال دقت را حفظ میکند.
برچسبگذاری خودکار
در این روش، الگوریتمهای هوش مصنوعی به صورت کامل دادهها را برچسبگذاری میکنند. این روش بسیار سریع است، اما ممکن است دقت کمتری داشته باشد و نیاز به بررسی و تصحیح توسط انسانها باشد.
همچنین، استفاده از پلتفرمهای تخصصی مانند Labelbox، Amazon SageMaker Ground Truth یا حتی ابزارهای متنباز مانند CVAT میتواند در برچسبگذاری دادهها کمککننده باشد.
چالشهای مرتبط با داده برچسبگذاریشده
در حالی که داده برچسبگذاریشده بسیار مهم است، تهیه آن با چالشهایی همراه است:
- هزینه و زمان: برچسبگذاری دستی گران و زمانبر است و نیاز به منابع انسانی زیادی دارد.
- دقت: در برخی موارد، برچسبگذاری خودکار ممکن است دقت کافی نداشته باشد و نیاز به بررسی دستی داشته باشد.
- مقیاسپذیری: با افزایش حجم دادهها، برچسبگذاری آنها دشوارتر میشود و نیاز به روشهای خودکار یا نیمه خودکار بیشتر میشود.
- تنوع دادهها: در برخی زمینهها مانند تشخیص بیماریها یا تشخیص احساسات، دادهها بسیار متنوع هستند و برچسبگذاری آنها پیچیدهتر میشود.
برای مقابله با این چالشها، استفاده از روشهای ترکیبی، ابزارهای خودکار و همکاری با متخصصان میتواند بسیار مؤثر باشد.
کاربردهای داده برچسبگذاریشده در هوش مصنوعی
داده برچسبگذاریشده در بسیاری از حوزههای هوش مصنوعی کاربرد دارد. برخی از این کاربردها عبارتند از:
- تشخیص تصویر: در سیستمهای تشخیص چهره، تشخیص اشیا و تشخیص بیماریهای پزشکی، دادههای برچسبگذاریشده نقش کلیدی دارند.
- پردازش زبان طبیعی: در سیستمهای ترجمه خودکار، پاسخگویی به سوالات و تحلیل احساسات، دادههای برچسبگذاریشده مانند متنهای همراه با برچسبهای احساسی استفاده میشوند.
- رباتیک: در آموزش رباتها برای تشخیص محیط و انجام وظایف مختلف، دادههای برچسبگذاریشده از محیط اطراف استفاده میشود.
- سیستمهای توصیه: در پلتفرمهای توصیهکننده مانند شبکههای اجتماعی یا سایتهای خرید آنلاین، دادههای برچسبگذاریشده مانند رفتار کاربران برای ارائه پیشنهادات دقیق استفاده میشود.
در واقع، هر جایی که هوش مصنوعی برای تصمیمگیری یا تشخیص استفاده میشود، داده برچسبگذاریشده نقش اساسی دارد.
نکات کاربردی برای استفاده بهتر از داده برچسبگذاریشده
برای استفاده بهتر از داده برچسبگذاریشده در پروژههای هوش مصنوعی، میتوانید به نکات زیر توجه کنید:
- کیفیت دادهها: دادههای برچسبگذاریشده باید با کیفیت بالا و بدون خطا باشند. دادههای نادرست یا نامناسب میتوانند عملکرد مدل را کاهش دهند.
- تنوع دادهها: دادهها باید متنوع باشند تا مدل بتواند بهتر عمومیسازی کند و در شرایط مختلف عملکرد خوبی داشته باشد.
- مقیاسپذیری: در نظر داشته باشید که حجم دادهها ممکن است با زمان افزایش یابد و روشهای برچسبگذاری باید قابل مقیاس باشند.
- دستورالعملهای واضح: برای برچسبگذاری دستی، دستورالعملهای واضح و دقیق ارائه دهید تا کاربران بتوانند دادهها را به درستی برچسبگذاری کنند.
- ارزیابی مداوم: پس از برچسبگذاری، دادهها را ارزیابی کنید تا از دقت و کیفیت آنها اطمینان حاصل کنید.
همچنین، استفاده از ابزارهای مناسب و همکاری با تیمهای متخصص میتواند در بهبود کیفیت دادهها بسیار مؤثر باشد.
در پایان، داده برچسبگذاریشده یکی از ستونهای اصلی آموزش هوش مصنوعی است. بدون این دادهها، مدلها نمیتوانند به درستی یاد بگیرند و عملکرد خوبی داشته باشند. با درک اهمیت این دادهها و استفاده از روشهای مناسب برای تهیه و مدیریت آنها، میتوانید پروژههای هوش مصنوعی خود را به سطح بالاتری برسانید. برای اطلاعات بیشتر در مورد دادهها و هوش مصنوعی، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید.