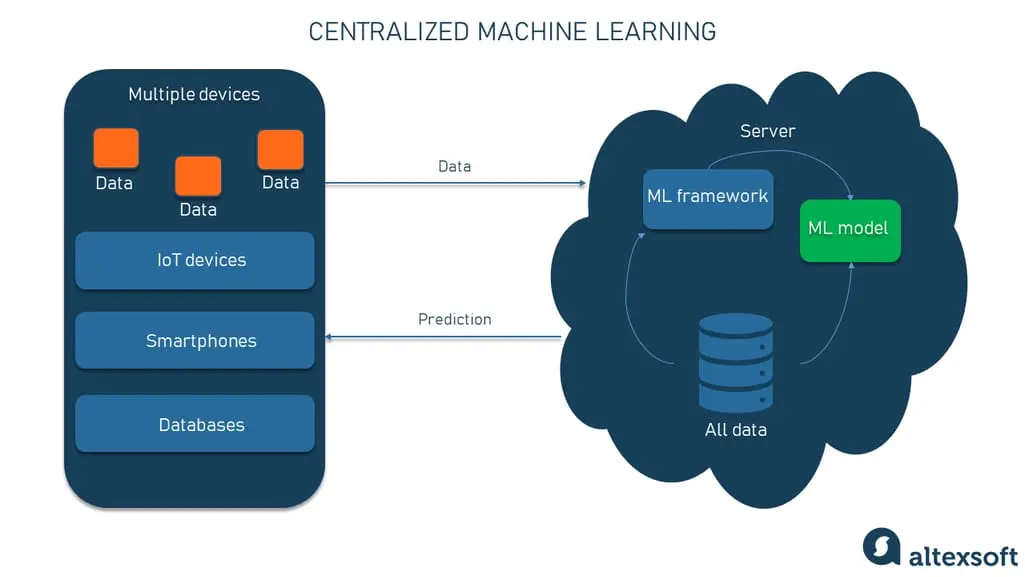
در دنیای هوش مصنوعی و یادگیری ماشین، حفظ حریم خصوصی دادهها یکی از چالشهای اصلی است. شرکتها و سازمانها اغلب با محدودیتهای قانونی و اخلاقی مواجه هستند که مانع از انتقال دادههای حساس به سرورهای مرکزی میشوند. در این میان، روشهای نوین آموزش مدلهای هوش مصنوعی بدون نیاز به انتقال دادههای خصوصی، راهحلهای جدیدی را ارائه میدهند. یکی از این روشها، یادگیری فدرال (Federated Learning) است که به عنوان یک تکنیک پیشرفته در حوزه یادگیری ماشین شناخته میشود.
یادگیری فدرال چگونه کار میکند؟ در این روش، مدل هوش مصنوعی در دستگاههای محلی (مانند گوشیهای هوشمند یا دستگاههای پزشکی) آموزش میبیند، بدون اینکه دادههای خصوصی کاربران به سرور مرکزی منتقل شود. به این ترتیب، دادهها در محل باقی میمانند و تنها پارامترهای مدل (و نه دادههای خام) برای بهبود مدل به سرور ارسال میشوند. این روش نه تنها حریم خصوصی را تضمین میکند، بلکه با کاهش نیاز به انتقال داده، هزینهها و زمان را نیز کاهش میدهد.
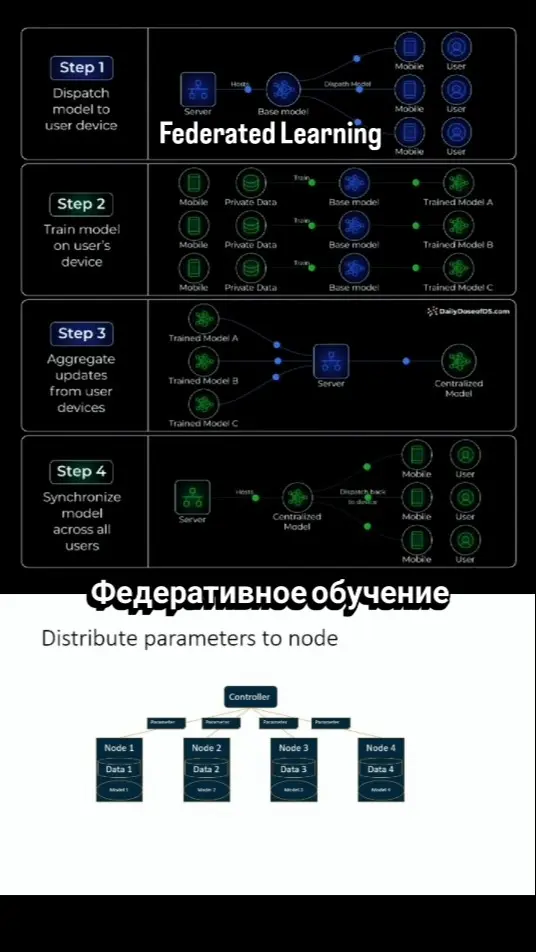
اما چگونه این روش بدون انتقال دادههای خصوصی، مدل را آموزش میدهد؟ در یادگیری فدرال، یک مدل اولیه در سرور مرکزی ایجاد میشود. سپس این مدل به دستگاههای محلی ارسال میشود و در آنجا با دادههای محلی آموزش میبیند. پس از آموزش، تنها تغییرات اعمالشده بر روی پارامترهای مدل (مانند وزنهای شبکه عصبی) به سرور بازمیگردند. سرور سپس این تغییرات را با مدل مرکزی ادغام میکند و مدل بهروزرسانیشده را دوباره به دستگاهها ارسال میکند. این فرآیند تکرار میشود تا مدل به حداکثر دقت برسد.
مزایای یادگیری فدرال
یادگیری فدرال مزایای متعددی دارد که آن را به یک روش جذاب برای سازمانها تبدیل کرده است:
- حفظ حریم خصوصی: دادههای کاربران هرگز از دستگاههای محلی خارج نمیشوند، بنابراین ریسک افشای اطلاعات شخصی کاهش مییابد.
- کاهش هزینه: انتقال حجم زیادی از دادهها به سرور مرکزی نیازی نیست، بنابراین هزینههای ذخیرهسازی و انتقال داده کاهش مییابد.
- کارایی: مدل در دستگاههای محلی آموزش میبیند، بنابراین زمان پاسخگویی و دقت مدل افزایش مییابد.
- مقیاسپذیری: این روش امکان آموزش مدل با استفاده از دادههای میلیونها دستگاه را فراهم میکند، بدون نیاز به جمعآوری دادهها در یک مکان مرکزی.
چگونه یادگیری فدرال کار میکند؟
فرآیند یادگیری فدرال شامل چند مرحله کلی است:
- ایجاد مدل اولیه: یک مدل هوش مصنوعی اولیه در سرور مرکزی ایجاد میشود.
- ارسال مدل به دستگاهها: مدل اولیه به دستگاههای محلی (مانند گوشیها یا دستگاههای پزشکی) ارسال میشود.
- آموزش محلی: دستگاهها با استفاده از دادههای محلی، مدل را آموزش میدهند و تغییرات اعمالشده بر روی پارامترهای مدل را محاسبه میکنند.
- ارسال تغییرات به سرور: دستگاهها تنها تغییرات پارامترهای مدل (و نه دادههای خام) را به سرور مرکزی ارسال میکنند.
- ادغام تغییرات: سرور تغییرات دریافتی را با مدل مرکزی ادغام میکند و مدل بهروزرسانیشده را دوباره به دستگاهها ارسال میکند.
- تکرار: این فرآیند تا رسیدن مدل به دقت مورد نظر تکرار میشود.
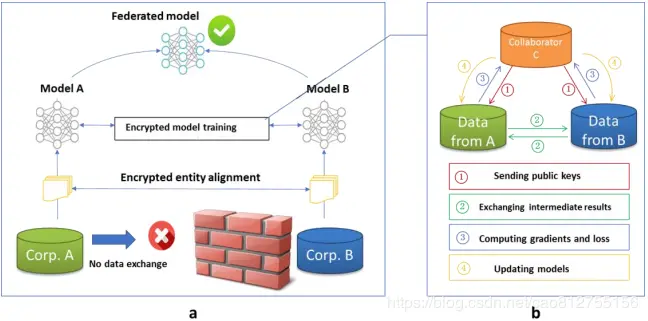
در این فرآیند، دادههای محلی هرگز از دستگاه خارج نمیشوند، بنابراین حریم خصوصی کاربران تضمین میشود. همچنین، این روش امکان استفاده از دادههای گستردهای را فراهم میکند که در شرایط معمولی به دلیل محدودیتهای قانونی یا فنی قابل استفاده نیستند.
نکات کاربردی در یادگیری فدرال
برای اجرای موفق یک پروژه یادگیری فدرال، باید به نکات کاربردی زیر توجه کرد:
- انتخاب مدل مناسب: انتخاب مدل هوش مصنوعی مناسب برای مشکل خاص بسیار مهم است. برخی مدلها برای یادگیری فدرال بهتر عمل میکنند.
- مدیریت دادهها: دادههای محلی باید به درستی سازماندهی و پیشپردازش شوند تا مدل بتواند به بهترین شکل آموزش ببیند.
- امنیت: انتقال پارامترهای مدل باید با پروتکلهای امنیتی قوی انجام شود تا از دستکاری یا دسترسی غیرمجاز جلوگیری شود.
- توزیع دستگاهها: دستگاههای شرکتکننده باید متنوع باشند تا مدل بتواند از دادههای گوناگون بهرهبرداری کند.
- ارزیابی مداوم: عملکرد مدل باید در طول فرآیند آموزش مداوم ارزیابی شود تا از دقت و کارایی آن اطمینان حاصل شود.
اشتباهات رایج در یادگیری فدرال
در حالی که یادگیری فدرال مزایای بسیاری دارد، برخی اشتباهات رایج میتوانند باعث کاهش کارایی یا حتی شکست پروژه شوند. از جمله این اشتباهات میتوان به موارد زیر اشاره کرد:
- نادیده گرفتن تنوع دادهها: اگر دستگاههای شرکتکننده دادههای مشابهی داشته باشند، مدل ممکن است به خوبی آموزش نبیند و دقت پایین داشته باشد.
- عدم توجه به امنیت: اگر انتقال پارامترهای مدل بدون پروتکلهای امنیتی انجام شود، ممکن است دادهها در معرض خطر قرار گیرند.
- انتخاب نادرست دستگاهها: اگر دستگاههای شرکتکننده ناکافی یا نامناسب باشند، مدل نمیتواند از دادههای کافی برای آموزش بهرهبرداری کند.
- عدم ارزیابی مداوم: اگر عملکرد مدل در طول فرآیند آموزش ارزیابی نشود، ممکن است مشکلاتی مانند bias یا overfitting ایجاد شود.
- نادیده گرفتن هزینههای محاسباتی: آموزش مدل در دستگاههای محلی ممکن است منابع محاسباتی زیادی را مصرف کند و اگر مدیریت نشود، باعث کاهش کارایی شود.
برای جلوگیری از این اشتباهات، باید به طراحی دقیق سیستم، انتخاب مدل مناسب و مدیریت دادهها توجه ویژهای داشت. همچنین، استفاده از ابزارهای مناسب برای ارزیابی و بهبود مداوم مدل بسیار مهم است.
چالشهای یادگیری فدرال
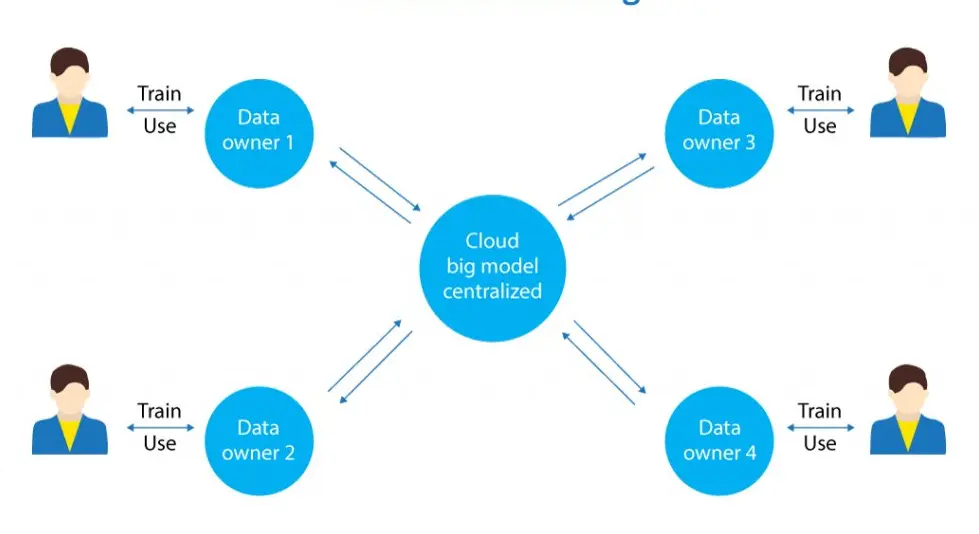
در حالی که یادگیری فدرال مزایای بسیاری دارد، همچنان چالشهایی نیز وجود دارد که باید به آنها توجه کرد:
- تنوع دادهها: اگر دادههای محلی بسیار متفاوت باشند، ادغام پارامترهای مدل ممکن است دشوار شود.
- امنیت: حتی اگر دادههای خام منتقل نشوند، پارامترهای مدل ممکن است اطلاعاتی در مورد دادههای محلی را در خود داشته باشند.
- کارایی: آموزش مدل در دستگاههای محلی ممکن است زمانبر باشد، به خصوص اگر دستگاهها منابع محاسباتی محدود داشته باشند.
- ارزیابی: ارزیابی دقت مدل در یادگیری فدرال دشوارتر از روشهای سنتی است، زیرا دادههای مرکزی برای ارزیابی وجود ندارد.
برای مقابله با این چالشها، تحقیقات جدیدی در زمینه بهبود الگوریتمهای یادگیری فدرال، افزایش امنیت و بهبود کارایی انجام میشود. همچنین، استفاده از تکنیکهای پیشرفته مانند differential privacy میتواند در کاهش ریسک افشای اطلاعات کمک کند.
یادگیری فدرال یک روش نوین و مؤثر برای آموزش مدلهای هوش مصنوعی بدون انتقال دادههای خصوصی است. این روش نه تنها حریم خصوصی را تضمین میکند، بلکه امکان استفاده از دادههای گستردهای را فراهم میآورد که در شرایط معمولی قابل استفاده نیستند. با توجه به مزایای این روش، سازمانها و شرکتها میتوانند از آن برای بهبود مدلهای خود استفاده کنند، اما باید به نکات کاربردی و چالشهای موجود توجه داشته باشند.
برای اطلاعات بیشتر در مورد تکنیکهای نوین یادگیری ماشین و هوش مصنوعی، میتوانید به مقالات مرتبط در تایم به تایم مراجعه کنید.